java stream API
Tung Bui Thanh (TungDaDev) (updated 6 months ago)12 mins read
Từ khi có mặt trong Java 8, Stream API đã đổi hẳn cách dân Java viết code: thay mấy vòng for lồng nhau dễ sai bằng các pipeline xử lý dữ liệu kiểu khai báo (declarative), dễ đọc hơn và đi theo lối lập trình hàm.
Có điều với nhiều anh em, Stream API vẫn là cái "hộp đen". Không ít hệ thống bị tụt throughput thảm hại, CPU lên 100%, thậm chí treo cả thread pool của server chỉ vì:
- Không hiểu Loop Fusion nên xếp sai thứ tự các toán tử trung gian.
- Nhầm giữa toán tử Stateless và Stateful, thế là Heap phình to.
- Xài
parallelStream()một cách vô tư, làm nghẽn luônForkJoinPool.commonPool()của cả ứng dụng Spring Boot.
Bài này lật mã nguồn OpenJDK ra xem Stream thực sự chạy thế nào bên dưới, từ cấu trúc Sink cho tới mấy nguyên tắc tối ưu hiệu năng ở tầm hệ thống.
# stream pipeline bên trong: sink chaining & loop fusion
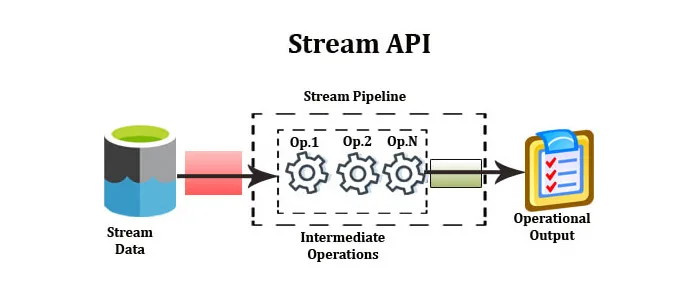
Trong Java, Stream không chứa dữ liệu. Nó chỉ mô tả một chuỗi phép biến đổi trên một nguồn dữ liệu (Collection, Array, hoặc I/O channel).
Một Stream Pipeline có 3 phần:
- Source (nguồn): cấp dữ liệu ban đầu thông qua một
Spliterator. - Intermediate Operations (toán tử trung gian):
filter,map,sorted,distinct... biến Stream này thành Stream khác. Tất cả đều Lazy Evaluation: chỉ ghi lại là sẽ làm gì, chưa tính gì cả. - Terminal Operation (toán tử kết thúc):
collect,reduce,findFirst,count... gọi tới thì mới bắt đầu tính, cho ra kết quả cuối hoặc side-effect.
# loop fusion chạy thế nào
Nhiều người nghĩ thế này: gọi .filter() thì Stream tạo ra một list tạm, rồi .map() lại duyệt list tạm đó thêm một vòng nữa. Nếu đúng vậy thì tốn RAM và CPU khủng khiếp.
Thực tế OpenJDK dùng Loop Fusion thông qua interface nội bộ java.util.stream.Sink:
Interface Sink<T> kế thừa Consumer<T>, có 4 method vòng đời:
begin(long size): báo cho downstream chuẩn bị nhận dữ liệu (ví dụ để cấp phát mảng đúng kích thước).accept(T value): nhận một phần tử, thoả điều kiện thì chuyển tiếp xuống downstream.cancellationRequested(): ngắt sớm (Short-circuiting). Cho phép dừng duyệt sớm, ví dụ khilimit()đã đủ số phần tử hoặcfindFirst()đã tìm thấy.end(): báo dữ liệu đã hết.
Nhờ vậy cả chuỗi toán tử trung gian được gộp lại thành đúng một vòng lặp. Mỗi phần tử từ nguồn đi xuyên qua cả chuỗi filter -> map -> limit -> toList rồi phần tử tiếp theo mới được xử lý.
Có một chi tiết nhỏ: pipeline không có toán tử ngắt sớm thì nguồn đẩy hết dữ liệu bằng forEachRemaining(). Còn khi có limit(), findFirst(), anyMatch()... thì OpenJDK chuyển sang vòng lặp tryAdvance() từng phần tử, trước mỗi lần lại hỏi cancellationRequested(), nhờ vậy mới dừng được giữa chừng.
# stateless vs stateful operations: bẫy tràn bộ nhớ
Toán tử trung gian chia làm hai nhóm, tốn tài nguyên khác nhau một trời một vực:
# đặt sai chỗ toán tử thì sao
Xem các đoạn code dưới, cùng muốn lấy 5 bản ghi đang active có score nhỏ nhất trong 10 triệu bản ghi:
// Cách 1: Thảm họa hiệu năng!
records.stream()
    .sorted(Comparator.comparing(Record::score)) // Copy cả 10 triệu phần tử ra mảng tạm rồi sort hết!
    .filter(Record::isActive)
    .limit(5)
    .toList();

// Cách 2: Filter trước, chỉ sort những bản ghi còn lại
records.stream()
    .filter(Record::isActive)
    .sorted(Comparator.comparing(Record::score))
    .limit(5)
    .toList();

// Cách 3: Top-K bằng heap kích thước K, bộ nhớ O(K), thời gian O(N log K)
PriorityQueue<Record> heap = new PriorityQueue<>(Comparator.comparing(Record::score).reversed());
records.stream()
    .filter(Record::isActive)
    .forEach(r -> {
        heap.offer(r);
        if (heap.size() > 5) heap.poll(); // Bỏ phần tử có score lớn nhất
    });
List<Record> top5 = heap.stream().sorted(Comparator.comparing(Record::score)).toList();
Đừng "tối ưu" bằng cách chèn .limit(100) trước .sorted(): lúc đó bạn chỉ sort 100 bản ghi active đầu tiên, kết quả là 5 bản ghi nhỏ nhất trong 100 bản ghi đó chứ không phải trong cả 10 triệu. Code chạy nhanh nhưng sai.
sorted() của JDK không biết phía sau có limit(5), nên dù đã filter, nó vẫn gom mọi phần tử còn lại vào bộ nhớ rồi sort hết. Nếu sau filter vẫn còn hàng triệu bản ghi mà chỉ cần vài phần tử đầu, cách 3 (heap) tiết kiệm hơn nhiều. Tốt nhất vẫn là đẩy việc này xuống database (ORDER BY score LIMIT 5 có index) nếu dữ liệu đến từ đó.
WARNING
Gọi .sorted() trên một stream vô hạn (Infinite Stream sinh từ Stream.generate() hoặc Stream.iterate()) là chương trình chạy mãi không dừng, ăn 100% CPU rồi sập với OutOfMemoryError: Java heap space.
# parallelStream & forkJoinPool commonPool: coi chừng
Java cho phép biến một Stream tuần tự thành chạy song song nhiều thread chỉ bằng một lệnh: .parallel() hoặc .parallelStream().
Nhưng đây cũng là một trong những tính năng bị lạm dụng nguy hiểm nhất trên Production.
# cả JVM xài chung một pool
Mặc định, mọi lệnh parallelStream() trong cả JVM đều chạy trên đúng một Thread Pool toàn cục: ForkJoinPool.commonPool().
Kích thước pool này cố định theo số CPU core của máy:
Pool Size = Runtime.getRuntime().availableProcessors() - 1Server có 8 vCPU thì commonPool() chỉ có đúng 7 worker thread, dùng chung cho cả ứng dụng, kể cả CompletableFuture.supplyAsync() / runAsync() không truyền executor và thư viện bên thứ 3. Con số này chỉnh được bằng system property java.util.concurrent.ForkJoinPool.common.parallelism, nhưng chỉnh pool chung chỉ là chữa cháy.
Nói cho chính xác thì thread gọi parallelStream() cũng tự tham gia xử lý phần việc của mình, nên một parallel stream khác lúc pool bị chiếm hết thường không treo hẳn mà chậm lại, gần như chạy tuần tự trên thread gọi. Thứ dễ treo thật là các tác vụ chỉ trông vào pool, như CompletableFuture.supplyAsync() không truyền executor: chúng nằm trong hàng đợi cho tới khi có worker rảnh.
# mấy quy tắc phải nhớ khi dùng parallelStream
- Tuyệt đối KHÔNG chạy Blocking I/O (gọi Database, gọi HTTP API, đọc file trên disk) bên trong
parallelStream(). Parallel Stream chỉ dành cho việc thuần ăn CPU (CPU-Bound tasks). - Dữ liệu phải đủ lớn: với tập nhỏ và logic đơn giản, chi phí chia nhỏ dữ liệu qua
Spliterator.trySplit()và đồng bộ thread trongForkJoinPoolthường còn chậm hơn chạy tuần tự trên một core. Gợi ý hay được nhắc tới từ Doug Lea: tích N × Q (số phần tử × chi phí xử lý mỗi phần tử) phải vượt khoảng 10,000 thì parallel mới có cơ hội nhanh hơn. Nguồn cũng cần chia đều được:ArrayList, mảng,IntStream.rangechia tốt;LinkedListhayStream.iteratechia rất tệ.
# tách parallelStream ra custom forkJoinPool riêng
Nếu bắt buộc phải chạy tính toán nặng mà không muốn ảnh hưởng tới phần còn lại của hệ thống, hãy nhốt nó vào một ForkJoinPool riêng:
@Service
public class AnalyticsService {

    // Pool độc lập dành riêng cho tác vụ nặng
    private final ForkJoinPool customHeavyComputationPool = new ForkJoinPool(4);

    @PreDestroy
    void shutdown() {
        customHeavyComputationPool.shutdown();
    }

    public List<ReportDto> computeHeavyAnalytics(List<RawData> dataset) {
        try {
            // Thực thi parallelStream bên trong bối cảnh của Custom Pool
            return customHeavyComputationPool.submit(() ->
                dataset.parallelStream()
                    .filter(RawData::isValid)
                    .map(this::heavyCpuCalculation)
                    .toList()
            ).get(); // Chờ kết quả an toàn
        } catch (InterruptedException e) {
            Thread.currentThread().interrupt(); // Chỉ khôi phục cờ interrupt khi thật sự bị ngắt
            throw new IllegalStateException("Bị ngắt khi chờ kết quả phân tích", e);
        } catch (ExecutionException e) {
            throw new IllegalStateException("Lỗi tính toán phân tích", e.getCause());
        }
    }
}
Mẹo này chạy được vì parallel stream gọi từ bên trong một worker của ForkJoinPool nào thì sẽ chia việc trên chính pool đó. Đây là hành vi của OpenJDK chứ không được ghi trong đặc tả của Stream API, nên nhớ viết test để phát hiện nếu một bản JDK sau thay đổi.
TIP
Với Spring Boot chạy Java 21+, nếu cần gọi network song song thì đừng dùng parallelStream(), hãy dùng Virtual Threads với Executors.newVirtualThreadPerTaskExecutor() hoặc CompletableFuture.
# cái giá của autoboxing: Stream<Integer> vs IntStream
Một lỗi hay gặp khác làm hiệu năng tụt khá nặng là dùng Stream của wrapper object thay vì Primitive Stream:
// KÉM HIỆU NĂNG: Sinh ra hàng triệu Integer wrapper objects
int sum = list.stream()
    .map(Record::getValue) // Trả về Integer -> Boxing
    .reduce(0, Integer::sum);

// TỐI ƯU HIỆU NĂNG: Sử dụng Primitive Specialization (IntStream)
int sumOptimized = list.stream()
    .mapToInt(Record::getValue) // Chuyển sang IntStream (Unboxed)
    .sum(); // Cộng thẳng trên int, không tạo object Integer nào
Đừng kỳ vọng IntStream.sum() được JIT biến thành lệnh SIMD: pipeline Stream có nhiều tầng gọi qua lại, JIT có vectorize được hay không là chuyện không đảm bảo. Cái lợi chắc chắn là không boxing, không sinh rác cho GC và không phải nhảy con trỏ đi đọc từng object Integer.
Java có sẵn 3 Primitive Stream: IntStream, LongStream và DoubleStream. Làm việc với số thì cứ ưu tiên mấy đứa này.
# những gì mới từ java 9 tới java 21+
| Phiên bản | Tính năng mới trong Stream API | Có ý nghĩa gì |
|---|---|---|
| Java 9 | takeWhile(Predicate) & dropWhile(Predicate) | Ngắt ngay trên Stream đã sắp xếp, không phải duyệt hết dữ liệu. |
| Java 9 | Stream.iterate(seed, hasNext, next) | Viết được vòng lặp kiểu for (int i=0; i<n; i++), thay cho cú pháp vô hạn cũ. |
| Java 16 | Stream.toList() | Tạo list bất biến (Unmodifiable List), gọn hơn collect(Collectors.toList()) và thường nhanh hơn chút. |
| Java 16 | Stream.mapMulti() | Đẩy phần tử thẳng qua Consumer, không phải tạo một Stream con cho mỗi phần tử như flatMap. |
| Java 22-24 | Stream Gatherers (JEP 461/473/485) | Tự viết được Intermediate Operation theo ý mình (Windowing, Folding, Deduplication), chuyện mà trước đây không làm được. |
Stream Gatherers là preview ở Java 22 (JEP 461) và Java 23 (JEP 473), chính thức từ Java 24 (JEP 485).
# ví dụ takeWhile làm được gì
// Giả sử dữ liệu logs đã được sắp xếp theo timestamp tăng dần
List<LogEvent> recentLogs = sortedLogs.stream()
    // takeWhile dừng duyệt NGAY LẬP TỨC khi gặp bản ghi vượt quá mốc thời gian!
    .takeWhile(log -> log.timestamp().isBefore(cutoffTime))
    .toList();
# tổng kết & checklist
- Hiểu Loop Fusion: Stream gộp các bước xử lý thành một vòng lặp duy nhất nhờ
Sink Chaining. - Cẩn thận với Stateful Operations: luôn lọc (
filter) và thu hẹp dữ liệu (limit) trước khi gọi mấy toán tử tốn bộ nhớ nhưsorted()haydistinct(). - Không dùng Parallel Stream cho I/O:
ForkJoinPool.commonPool()là tài nguyên chung của cả JVM, chỉ dùng parallel cho việc nặng CPU trên tập dữ liệu lớn. - Ưu tiên Primitive Streams: dùng
IntStream,LongStream,DoubleStreamđể khỏi tốn chi phí Autoboxing và tận dụng tốt CPU L1/L2 Cache. - Cập nhật code: có thể thay
collect(Collectors.toList())bằngStream.toList()(Java 16+), nhưng nhớ list trả về là bất biến: chỗ nào sau đó cònadd()/remove()/sort()trên list sẽ némUnsupportedOperationException. KhácCollectors.toUnmodifiableList(),Stream.toList()vẫn cho phép phần tửnull.
Chỉ là những ghi chép cá nhân với hy vọng mang lại chút giá trị. Nếu thấy hữu ích, đừng ngại chia sẻ cho bạn bè & đồng nghiệp nhé!
Happy coding 😎 👍🏻 🚀 🔥.