java ThreadPoolExecutor
Tung Bui Thanh (TungDaDev)15 mins read
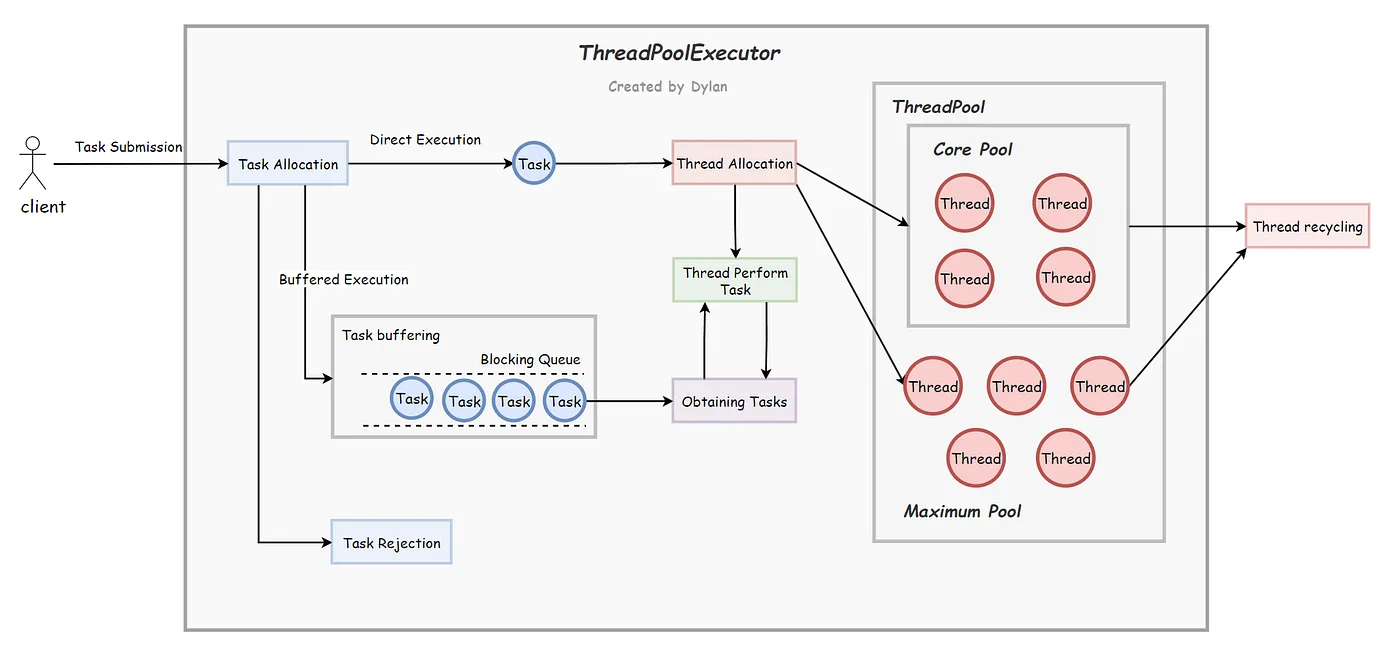
Ở hệ thống phân tán hay backend Java cần hiệu năng cao, quản lý thread cho đàng hoàng là ranh giới giữa một service chạy êm và một service sập vì cạn tài nguyên.
Gần như dev Java nào cũng từng tạo ThreadPoolExecutor hoặc xài mấy hàm tiện ích trong java.util.concurrent.Executors. Nhưng hỏi kỹ thì ít ai trả lời được:
- Vì sao
Executors.newFixedThreadPool()vàExecutors.newCachedThreadPool()bị nhiều coding guideline cấm dùng trên production? - Biến atomic
ctlgói bit (bit-packing) thế nào để điều khiển máy trạng thái của thread pool? - Vì sao class nội bộ
Workerlại tự kế thừaAbstractQueuedSynchronizer(AQS) chứ không dùngReentrantLock? - Làm sao dựng cơ chế backpressure và graceful shutdown để không mất những giao dịch đang xử lý dở?
Bài này đọc source ThreadPoolExecutor trong JDK (class viết thuần Java, do Doug Lea viết cho JSR-166) rồi đi tới cách dùng thật trên production.
# executors static factory methods và hiểm hoạ OOM
Coding guideline của nhiều công ty công nghệ lớn (như Alibaba Java Coding Guidelines) cấm hẳn việc dùng class Executors để tạo thread pool trên production. Lý do nằm ở mấy thông số mặc định nguy hiểm mà nó giấu bên trong:
Executors.newFixedThreadPool(n): dùng hàng đợi không giới hạnLinkedBlockingQueue, sức chứa mặc định2^31 - 1 ≈ 2.14 tỷ phần tử. Khi service phía downstream chậm I/O, request mới vẫn cứ đổ về và xếp hàng trong heap. Kết quả là app văngjava.lang.OutOfMemoryError: Java heap space, còn cơ chế rejection thì không bao giờ được kích hoạt vì queue chẳng bao giờ đầy.newSingleThreadExecutor()cũng dùng đúng loại queue này, vànewScheduledThreadPool()dùngDelayedWorkQueuekhông giới hạn, nên cùng chung rủi ro.Executors.newCachedThreadPool(): cho số thread tối đa (maximumPoolSize) phình tới2.14 tỷ. Mỗi platform thread của Java là một OS thread, kèm một vùng stack riêng (mặc định 1MB trên Linux x64, chỉnh bằng-Xss). Gặp một đợt traffic spike, pool cứ thế đẻ thêm thread tới khi chạm giới hạn số thread của hệ điều hành hoặc container (ulimit -u,pids.maxcủa cgroup) hay cạn bộ nhớ native, rồi văngjava.lang.OutOfMemoryError: unable to create native thread. Lúc đó cả JVM gần như tê liệt, vì việc gì cần tạo thread mới cũng thất bại.
WARNING
Quy tắc số 1: luôn tạo ThreadPoolExecutor trực tiếp bằng constructor, với hàng đợi có giới hạn (bounded queue) và số thread tối đa ghi rõ ràng.
Từ Java 21 có thêm virtual thread (Executors.newVirtualThreadPerTaskExecutor()): mỗi task một virtual thread rất rẻ, nên với việc chủ yếu chờ I/O thì không cần pool lớn nữa. Nhưng "không giới hạn thread" không có nghĩa là không giới hạn tải: database hay service phía sau vẫn chỉ chịu được chừng ấy kết nối, nên vẫn phải chặn đồng thời bằng Semaphore hoặc connection pool. Phần còn lại của bài vẫn áp dụng cho platform thread, loại mà phần lớn code hiện nay vẫn đang dùng.
# biến ctl và máy trạng thái
Trong source của ThreadPoolExecutor, trạng thái vòng đời của pool và số worker thread đang chạy được gói chung vào đúng một biến atomic:
private final AtomicInteger ctl = new AtomicInteger(ctlOf(RUNNING, 0));Sao tác giả không tách thành 2 biến (volatile int runState và AtomicInteger workerCount) cho dễ đọc?
Vì muốn đảm bảo atomicity trong môi trường đa luồng khắc nghiệt mà không cần lock (lock-free), thì việc đổi trạng thái vòng đời và tăng giảm số worker phải nằm gọn trong một phép CAS (Compare-And-Swap) duy nhất.
Source JDK chia 32 bit của ctl làm 2 phần:
- 3 bit cao (high-order bits): lưu trạng thái vòng đời của pool (
runState). - 29 bit thấp (low-order bits): lưu số thread hiện có (
workerCount), nên pool quản lý được tối đa2^29 - 1 ≈ 536,870,911thread.
ctl (32 bits) Layout:
[ 1 1 1 ] [ 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 ]
  ^
  |-- 3 bits: RUNNING (-1 << 29 = 111 in two's complement)
      |---------------- 29 bits: workerCount (0 to 536M) ---------------|
# vòng đời máy trạng thái của ThreadPoolExecutor
RUNNING(-1 << 29): nhận task mới và xử lý task trong hàng đợi.SHUTDOWN(0 << 29): không nhận task mới, nhưng vẫn xử lý nốt task còn trong hàng đợi.STOP(1 << 29): không nhận task mới, bỏ luôn task trong hàng đợi, và gửiinterrupt()tới mọi worker đang chạy.TIDYING(2 << 29): mọi task đã xong,workerCountvề 0.TERMINATED(3 << 29): hookterminated()đã chạy xong, pool đóng hẳn.
# giải mã Worker và AQS lock
Trong ThreadPoolExecutor, mỗi thread không phải một instance Thread trần trụi, mà được bọc trong một object Worker:
private final class Worker extends AbstractQueuedSynchronizer implements Runnable {
    final Thread thread;
    Runnable firstTask;
    volatile long completedTasks;
    // ...
}
Vì sao Worker phải tự kế thừa AbstractQueuedSynchronizer để làm một cái mutex, chứ không xài luôn ReentrantLock có sẵn?
Vì ReentrantLock cho phép tái nhập (reentrancy), còn Worker bắt buộc phải là khoá KHÔNG tái nhập (non-reentrant lock)!
Khi ThreadPoolExecutor làm mấy việc quản trị như interruptIdleWorkers() (ngắt các thread đang rảnh lúc gọi shutdown()), nó sẽ thử lấy khoá của worker:
if (w.tryLock()) { // Thử lấy khóa của Worker
    try {
        w.thread.interrupt(); // Chỉ ngắt nếu lấy được khóa thành công!
    } finally {
        w.unlock();
    }
}- Nếu worker đang thật sự chạy task của người dùng, khoá AQS của nó đang bị giữ.
tryLock()trả vềfalse, và pool không ngắt thread này. - Nếu worker đang rảnh, ngồi chờ task mới ở
workQueue.take(), khoá đang trống.tryLock()thành công, thread nhận cờinterrupt(), thức dậy và thoát khỏi vòng lặp worker. - Còn nếu dùng
ReentrantLock: lỡ task của người dùng gọi ngược lại một method nào đó của chính executor trên cùng thread, khoá tái nhập sẽ cho worker tự ngắt chính nó, làm hỏng trạng thái đang chạy!
# chính sách xử lý từ chối và backpressure
Trước hết cần nắm thứ tự execute() xử lý một task mới, vì nó ngược với trực giác của nhiều người:
- Số thread còn dưới
corePoolSizethì tạo thread mới để chạy task, kể cả khi đang có thread rảnh. - Đủ core rồi thì bỏ task vào queue.
- Queue đầy thì mới tạo thêm thread, tới tối đa
maximumPoolSize. - Queue đầy và thread đã chạm
maximumPoolSizethì giao task choRejectedExecutionHandler.
Nghĩa là pool chỉ nở quá core khi queue đã đầy. Đặt queue 10.000 với core 10, max 100 thì gần như lúc nào cũng chỉ có 10 thread chạy, 90 thread kia chỉ xuất hiện khi đã có 10.000 task xếp hàng. Muốn pool nở sớm hơn thì dùng queue nhỏ, hoặc đặt core bằng max kèm allowCoreThreadTimeOut(true) để thread rảnh vẫn được thu hồi.
# AbortPolicy mặc định
Ném luôn RejectedExecutionException. Hợp với API đồng bộ (synchronous REST API) cần báo lỗi ngay cho client biết hệ thống đang quá tải. Lưu ý DiscardPolicy và DiscardOldestPolicy vứt task mà không báo gì; nếu task đó được đưa vào bằng submit() thì Future của nó sẽ không bao giờ hoàn thành, ai gọi get() không có timeout sẽ treo mãi.
# CallerRunsPolicy và backpressure tự nhiên
Thay vì từ chối, thread đang gọi (ví dụ HTTP request thread của Tomcat) sẽ tự chạy luôn task đó:
- Nhờ vậy có sẵn một cái phanh tự nhiên (negative feedback loop): thread gọi đang bận chạy task nên không nhận thêm request mới từ socket được.
- Lưu lượng vào hệ thống tự chậm lại cho tới khi thread pool xử lý bớt backlog trong queue.
- Cái giá: task chạy trên thread của người gọi, nên request đó chậm hẳn, và nếu pool đã
shutdown()thì task bị bỏ lặng lẽ.
# tự viết rejection handler cho production
Với hệ thống event-driven hoặc xử lý giao dịch tài chính, ném exception hay vứt task đi đều không chấp nhận được. Cần một handler riêng:
package com.tungdadev.concurrency;

import io.micrometer.core.instrument.Counter;
import io.micrometer.core.instrument.MeterRegistry;
import org.slf4j.Logger;
import org.slf4j.LoggerFactory;

import java.util.concurrent.RejectedExecutionHandler;
import java.util.concurrent.ThreadPoolExecutor;

public class ResilientRejectionHandler implements RejectedExecutionHandler {

    private static final Logger log = LoggerFactory.getLogger(ResilientRejectionHandler.class);
    private final Counter rejectionCounter;
    private final DeadLetterQueueService dlqService;

    public ResilientRejectionHandler(MeterRegistry registry, DeadLetterQueueService dlqService) {
        this.rejectionCounter = registry.counter("threadpool.task.rejected.total");
        this.dlqService = dlqService;
    }

    @Override
    public void rejectedExecution(Runnable r, ThreadPoolExecutor executor) {
        rejectionCounter.increment();
        log.warn("ThreadPool saturated! Queue size: {}, Active threads: {}",
                executor.getQueue().size(), executor.getActiveCount());

        if (executor.isShutdown()) {
            log.error("Executor is already shut down. Dropping task.");
            return;
        }

        // Đẩy task vào Kafka DLQ hoặc lưu trữ thứ cấp để tái xử lý sau.
        // Lưu ý: task đưa vào bằng submit() đã bị bọc thành FutureTask (hoặc bị bọc bởi wrapper MDC như cấu hình bên dưới),
        // nên instanceof TrackableTask chỉ đúng khi bạn execute() thẳng một TrackableTask không qua lớp bọc nào.
        if (r instanceof TrackableTask trackable) {
            dlqService.pushToDeadLetter(trackable.getPayload());
        } else {
            // Fallback: Chạy trực tiếp trên Caller Thread để không mất dữ liệu
            r.run();
        }
    }
}
TIP
Mẹo backpressure: ghép CallerRunsPolicy với một semaphore giới hạn, quá ngưỡng thì trả HTTP status 429 Too Many Requests. Vừa giữ cho hạ tầng không sập, vừa báo rõ cho client để nó retry theo kiểu exponential backoff.
# quy trình graceful shutdown 2 pha
Chạy trên Kubernetes thì mỗi lần rolling update hay scale-down, container sẽ nhận tín hiệu SIGTERM. Không tắt thread pool cẩn thận là cả trăm giao dịch đang làm dở bị cắt ngang, dữ liệu trong DB lệch nhau.
Javadoc của ExecutorService có sẵn một mẫu tắt 2 pha (shutdownAndAwaitTermination): shutdown() trước, chờ một lúc, chưa xong thì shutdownNow() rồi chờ thêm. Phiên bản dưới đây chia đôi tổng thời gian cho hai lần chờ:
package com.tungdadev.concurrency;

import org.slf4j.Logger;
import org.slf4j.LoggerFactory;

import java.time.Duration;
import java.util.concurrent.ExecutorService;
import java.util.concurrent.TimeUnit;

public final class ThreadPoolGracefulShutdown {

    private static final Logger log = LoggerFactory.getLogger(ThreadPoolGracefulShutdown.class);

    private ThreadPoolGracefulShutdown() {}

    public static void shutdownGracefully(ExecutorService pool, Duration timeout) {
        // PHA 1: Chặn tiếp nhận task mới, cho phép task cũ trong queue hoàn tất
        pool.shutdown();
        long halfTimeout = timeout.toMillis() / 2;

        try {
            // Chờ một nửa thời gian cho các task đang xử lý kết thúc
            if (!pool.awaitTermination(halfTimeout, TimeUnit.MILLISECONDS)) {
                log.warn("ThreadPool did not terminate in {} ms, issuing shutdownNow()...", halfTimeout);

                // PHA 2: Nếu quá hạn, phát tín hiệu ngắt (interrupt) cưỡng bức
                pool.shutdownNow();

                // Chờ tiếp nửa thời gian còn lại để các luồng phản hồi lại cờ interrupt
                if (!pool.awaitTermination(halfTimeout, TimeUnit.MILLISECONDS)) {
                    log.error("ThreadPool failed to terminate permanently!");
                }
            }
        } catch (InterruptedException ie) {
            log.error("Shutdown interrupted, forcing immediate halt...");
            pool.shutdownNow();
            Thread.currentThread().interrupt(); // Giữ nguyên trạng thái ngắt của caller thread
        }
    }
}
Vài điểm cần khớp khi dùng thực tế. Tổng timeout phải nhỏ hơn terminationGracePeriodSeconds của pod (mặc định 30 giây), nếu không kubelet sẽ SIGKILL trước khi bạn chờ xong. shutdownNow() chỉ gửi interrupt(); task nào không kiểm tra cờ ngắt hay đang kẹt ở I/O không phản hồi interrupt thì vẫn chạy tiếp. Từ Java 19, ExecutorService có thêm close() (dùng được với try-with-resources), nhưng nó chờ tới khi mọi task xong, không có timeout. Còn nếu dùng ThreadPoolTaskExecutor của Spring thì đã có sẵn setWaitForTasksToCompleteOnShutdown(true) và setAwaitTerminationSeconds(...).
# cấu hình ThreadPool mẫu cho microservices
Đây là một cấu hình đầy đủ: ThreadFactory đặt tên rõ ràng, hàng đợi có giới hạn, và truyền context (Trace ID, MDC log) sang thread chạy task.
Chỗ dễ sai là thời điểm chụp MDC. Một worker thread sống lâu và chạy task của hàng nghìn request khác nhau, nên context phải được chụp lúc submit từng task, không phải lúc tạo thread. Bọc trong ThreadFactory thì cả đời worker đó sẽ mang trace ID của request đầu tiên đã làm nó được tạo ra.
@Configuration
public class EnterpriseThreadPoolConfig {

    // destroyMethod = "" tắt việc Spring tự đoán hàm hủy (close()/shutdown()).
    // Nhớ gọi ThreadPoolGracefulShutdown.shutdownGracefully(...) trong @PreDestroy hoặc SmartLifecycle.
    @Bean(name = "paymentProcessingPool", destroyMethod = "")
    public ThreadPoolExecutor paymentProcessingPool(MeterRegistry registry, DeadLetterQueueService dlq) {
        int coreThreads = Runtime.getRuntime().availableProcessors() * 2;
        int maxThreads = coreThreads * 4;
        int queueCapacity = 1000;

        ThreadFactory namedFactory = new ThreadFactory() {
            private final AtomicInteger count = new AtomicInteger(1);
            @Override
            public Thread newThread(Runnable r) {
                Thread t = new Thread(r, "payment-worker-" + count.getAndIncrement());
                t.setDaemon(false);
                t.setPriority(Thread.NORM_PRIORITY);
                return t;
            }
        };

        return new ThreadPoolExecutor(
                coreThreads,
                maxThreads,
                60L, TimeUnit.SECONDS,
                new ArrayBlockingQueue<>(queueCapacity),
                namedFactory,
                new ResilientRejectionHandler(registry, dlq)
        ) {
            // Chụp MDC tại thời điểm submit từng task (submit() cũng đi qua execute())
            @Override
            public void execute(Runnable command) {
                super.execute(wrapWithMdc(command));
            }
        };
    }

    private static Runnable wrapWithMdc(Runnable task) {
        Map<String, String> contextMap = MDC.getCopyOfContextMap();
        return () -> {
            // Giữ lại MDC cũ: khi task bị chạy trên chính thread gọi (CallerRuns / fallback r.run()),
            // clear() thẳng tay sẽ xoá mất context của request đang gọi
            Map<String, String> previous = MDC.getCopyOfContextMap();
            if (contextMap != null) {
                MDC.setContextMap(contextMap);
            } else {
                MDC.clear();
            }
            try {
                task.run();
            } finally {
                if (previous != null) {
                    MDC.setContextMap(previous);
                } else {
                    MDC.clear();
                }
            }
        };
    }
}
Trong app Spring, cách gọn hơn là dùng ThreadPoolTaskExecutor với một TaskDecorator làm đúng việc của wrapWithMdc. Nếu đã dùng Micrometer Tracing thì ContextPropagatingTaskDecorator (Spring 6.1+) truyền trace context sang thread chạy task, kéo theo cả traceId/spanId trong MDC.
Còn con số availableProcessors() * 2 cho core chỉ là điểm xuất phát. Công thức trong Java Concurrency in Practice là số thread ≈ số CPU × mức sử dụng CPU mong muốn × (1 + thời gian chờ / thời gian tính): task càng chờ I/O nhiều thì càng cần nhiều thread. Đo thời gian chờ thật rồi chỉnh, và nhớ rằng availableProcessors() trong container trả về theo CPU limit của cgroup.
# tổng kết
ThreadPoolExecutor không chỉ là một cái hàng đợi kèm vài thread, nó là cả một bộ điều phối tài nguyên thu nhỏ.
Mấy điều nên nắm chắc:
- Tránh xa factory methods của
Executors: luôn đặt bounded queue và max pool size rõ ràng. - Hiểu
ctl: trạng thái vòng đời và số worker được cập nhật bằng một phép CAS, không cần lock. - Hiểu thứ tự core → queue → max: pool chỉ nở quá core khi queue đã đầy.
- Hiểu khoá của
Worker: mutex AQS không tái nhập giữ cho task đang chạy không bị ngắt sai lúc. - Backpressure: dùng
CallerRunsPolicyhoặc custom DLQ để hệ thống trụ được khi tải tăng đột ngột. - Tắt cho an toàn: luôn làm graceful shutdown 2 pha để dữ liệu giao dịch không bị dở dang.
Tài liệu tham khảo:
- Doug Lea: Concurrent Programming in Java - Design Principles and Patterns
- Java Platform, Standard Edition API Specification - ThreadPoolExecutor
- Brian Goetz: Java Concurrency in Practice (Chapter 8: Applying Thread Pools)
Chỉ là những ghi chép cá nhân với hy vọng mang lại chút giá trị. Nếu thấy hữu ích, đừng ngại chia sẻ cho bạn bè & đồng nghiệp nhé!
Happy coding 😎 👍🏻 🚀 🔥.