kafka advance
Tung Bui Thanh (TungDaDev)34 mins read
Biết dùng Kafka là một chuyện. Vận hành Kafka ở production mà ngủ ngon là chuyện khác.
Bài trước mình đã nói về kiến trúc cơ bản, các pattern cho Producer/Consumer và vài pattern hay gặp. Bài này nói tiếp những thứ bạn sẽ cần khi hệ thống lớn dần: Kafka Connect, Schema Registry, bảo mật, Exactly-Once Semantics, testing, Kafka trên K8s và chuyện vận hành hằng ngày.
# kafka connect: integration không cần code
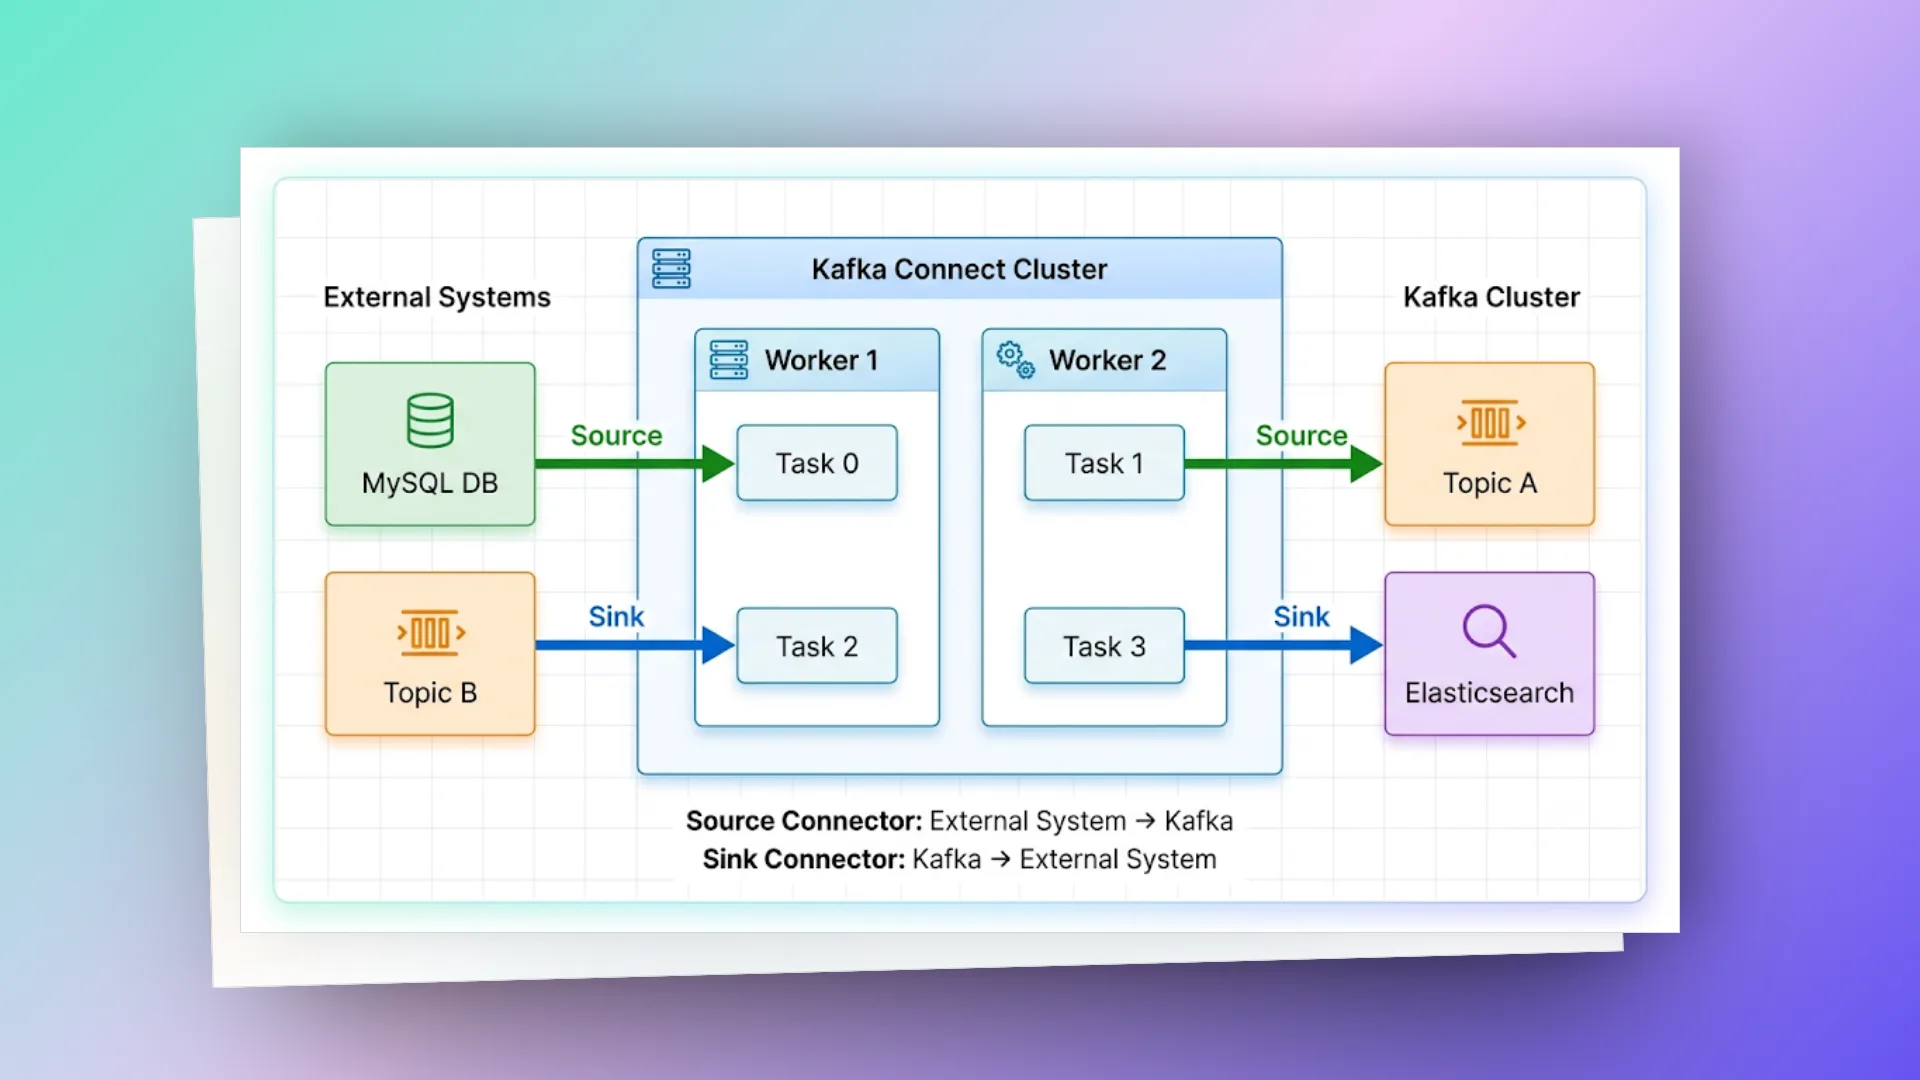
Kafka Connect là framework để đẩy data qua lại giữa Kafka và hệ thống bên ngoài (database, file system, search engine...) mà không phải tự viết code producer/consumer. Bạn chỉ khai báo connector bằng JSON, gửi lên Connect cluster qua REST API, còn chuyện poll, retry, lưu offset, chia task cho nhiều worker thì Connect lo.
# kiến trúc kafka connect
# hai loại connector
| Source Connector | Sink Connector | |
|---|---|---|
| Hướng | External → Kafka | Kafka → External |
| Ví dụ | MySQL → Kafka | Kafka → Elasticsearch |
| Use case | CDC, Log ingestion | Search indexing, Data warehouse |
# ví dụ: jdbc source connector: MySQL to Kafka
// POST http://localhost:8083/connectors
{
  "name": "mysql-source-orders",
  "config": {
    "connector.class": "io.confluent.connect.jdbc.JdbcSourceConnector",
    "connection.url": "jdbc:mysql://mysql:3306/ecommerce",
    "connection.user": "${file:/secrets/mysql.properties:user}",
    "connection.password": "${file:/secrets/mysql.properties:password}",

    "table.whitelist": "orders,order_items",

    "mode": "timestamp+incrementing",
    "incrementing.column.name": "id",
    "timestamp.column.name": "updated_at",

    "topic.prefix": "mysql.",
    "poll.interval.ms": "1000",

    "transforms": "createKey,extractInt",
    "transforms.createKey.type": "org.apache.kafka.connect.transforms.ValueToKey",
    "transforms.createKey.fields": "id",
    "transforms.extractInt.type": "org.apache.kafka.connect.transforms.ExtractField$Key",
    "transforms.extractInt.field": "id"
  }
}
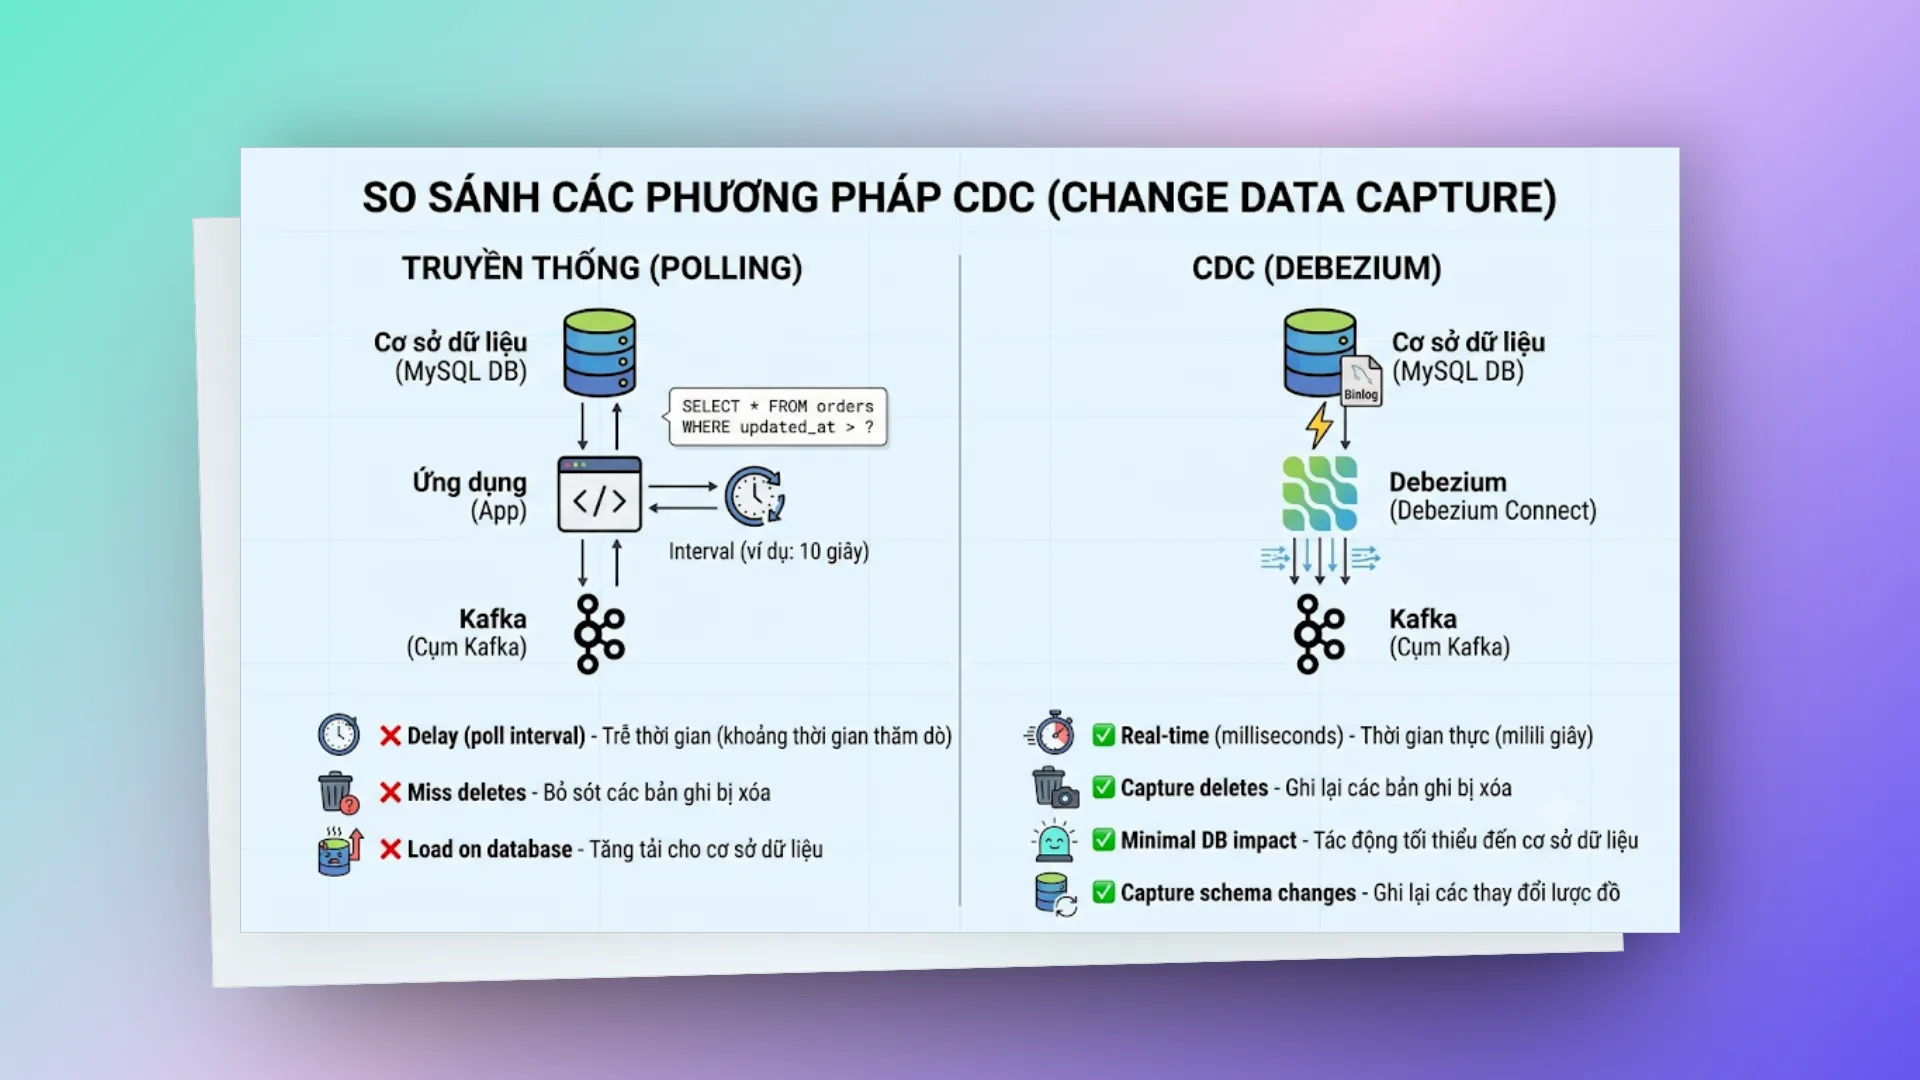
Kết quả: mỗi row trong bảng orders thành một message trong topic mysql.orders. Khi row được update (và updated_at đổi theo), connector sẽ publish thêm một message mới. Lưu ý JDBC source chỉ thấy được thay đổi qua câu query định kỳ: row bị xoá thì nó không biết, hai lần update trong cùng một khoảng poll thì chỉ thấy trạng thái cuối. Cần bắt đủ mọi thay đổi thì dùng CDC kiểu Debezium (phần dưới).
# ví dụ: elasticsearch sink connector
{
  "name": "elasticsearch-sink-orders",
  "config": {
    "connector.class": "io.confluent.connect.elasticsearch.ElasticsearchSinkConnector",
    "connection.url": "http://elasticsearch:9200",

    "topics": "mysql.orders",
    "key.ignore": "false",
    "schema.ignore": "true",

    "behavior.on.null.values": "delete",
    "write.method": "upsert",

    "batch.size": 200,
    "max.buffered.records": 5000,
    "flush.timeout.ms": 120000
  }
}
# single message transforms (SMTs)
SMT cho phép biến đổi từng message ngay trên đường đi mà không cần viết code. SMT hợp với mấy việc nhẹ như đổi tên topic, thêm/bỏ field, che dữ liệu nhạy cảm. Logic nặng hơn (join, aggregate) thì nên để Kafka Streams hoặc service riêng lo.
{
  "transforms": "route,timestamp,mask",

  // Route messages đến topic khác nhau dựa trên field
  "transforms.route.type": "org.apache.kafka.connect.transforms.RegexRouter",
  "transforms.route.regex": "mysql\\.(.*)",
  "transforms.route.replacement": "processed.$1",

  // Thêm timestamp field
  "transforms.timestamp.type": "org.apache.kafka.connect.transforms.InsertField$Value",
  "transforms.timestamp.timestamp.field": "ingested_at",

  // Mask sensitive fields
  "transforms.mask.type": "org.apache.kafka.connect.transforms.MaskField$Value",
  "transforms.mask.fields": "credit_card,ssn",
  "transforms.mask.replacement": "****"
}
# quản lý connectors qua rest api
# List tất cả connectors
GET http://localhost:8083/connectors

# Status của connector
GET http://localhost:8083/connectors/mysql-source-orders/status

# Pause connector
PUT http://localhost:8083/connectors/mysql-source-orders/pause

# Resume connector
PUT http://localhost:8083/connectors/mysql-source-orders/resume

# Restart failed task
POST http://localhost:8083/connectors/mysql-source-orders/tasks/0/restart

# Delete connector
DELETE http://localhost:8083/connectors/mysql-source-orders
# schema registry: contract giữa producer và consumer
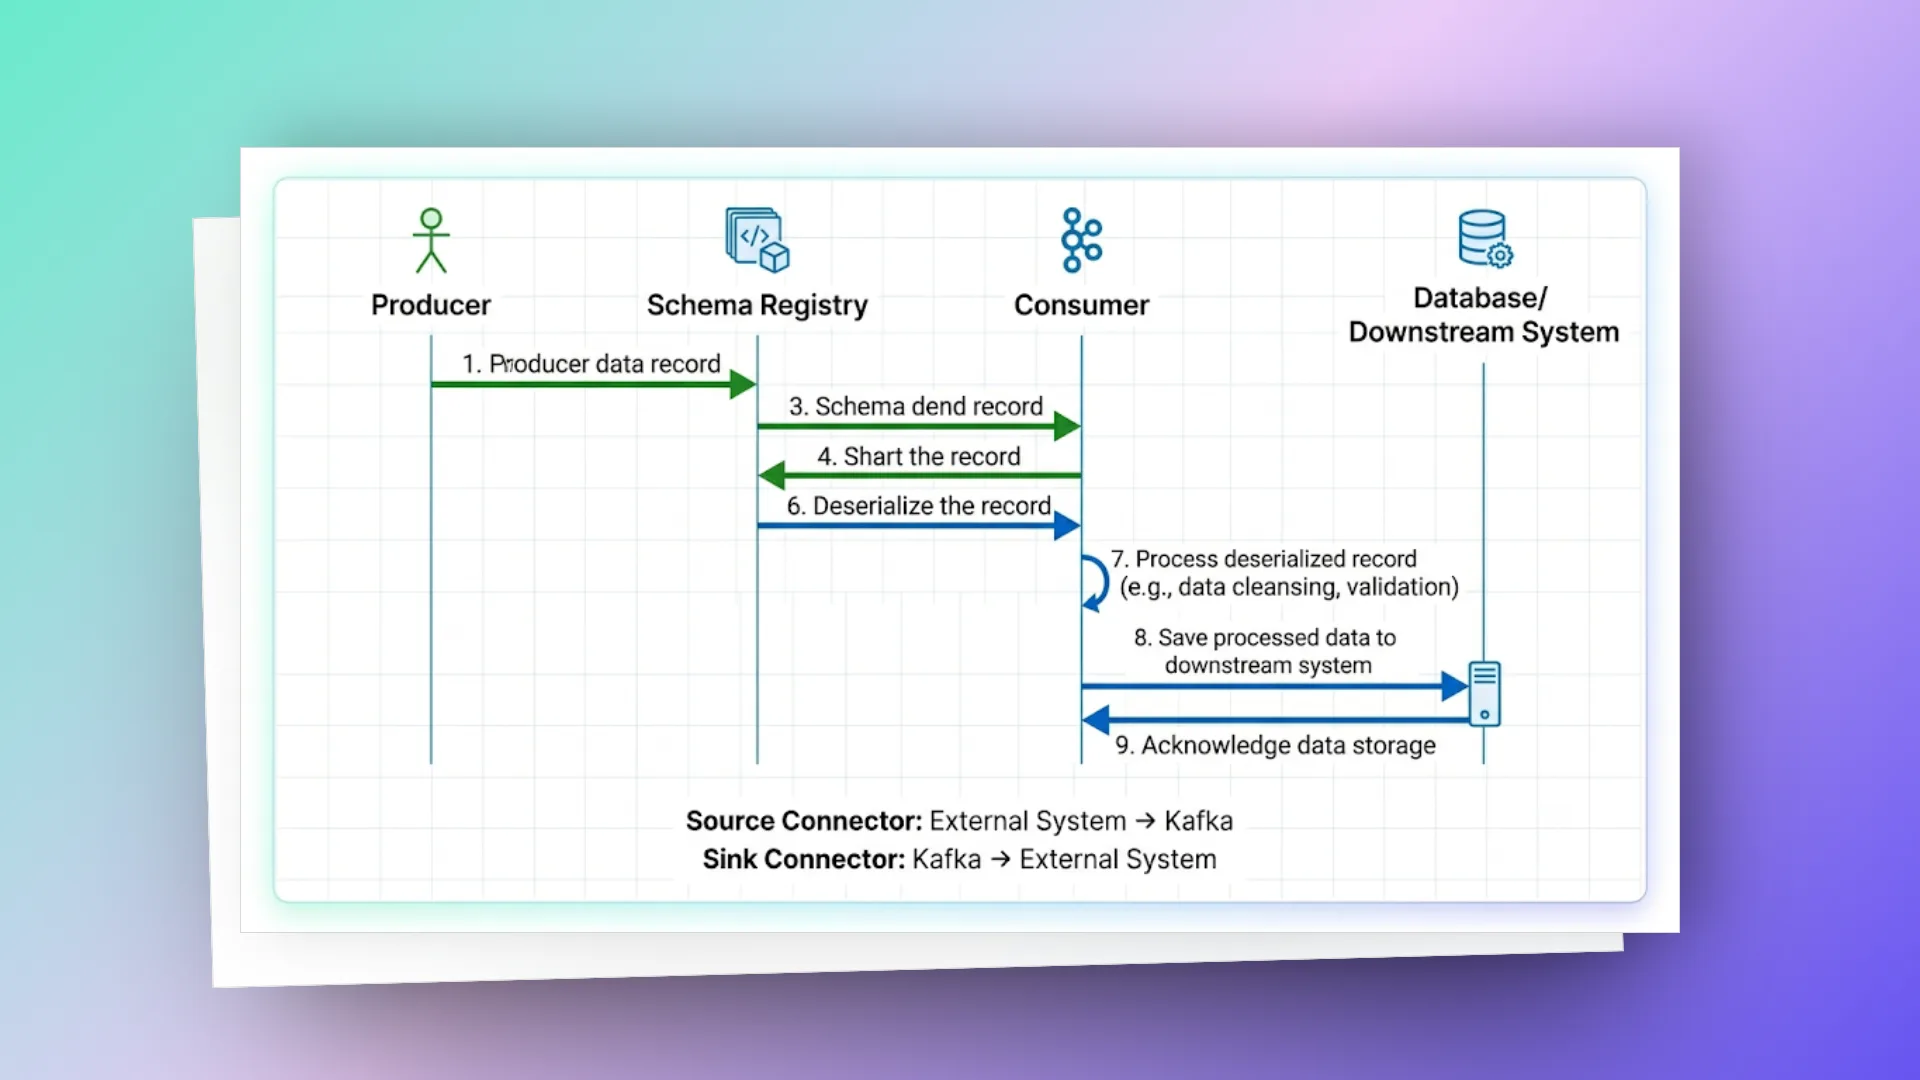
Khi có 50 service cùng đọc/ghi một topic, bạn cần một chỗ quản lý schema chung. Đó là việc của Schema Registry. Producer đăng ký schema lên registry và nhận về một schema ID; mỗi message chỉ mang theo ID đó (vài byte ở đầu payload) thay vì cả schema. Consumer đọc ID, lấy schema từ registry (có cache) rồi deserialize. Registry còn kiểm tra schema mới có tương thích với bản cũ không trước khi cho đăng ký, nên một thay đổi phá vỡ consumer sẽ bị chặn ngay từ lúc deploy producer.
# schema registry hoạt động thế nào?
# compatibility modes
| Mode | Cho phép | Use case |
|---|---|---|
| BACKWARD | Xóa fields, thêm fields có default | Consumer mới đọc data cũ |
| FORWARD | Thêm fields, xóa fields có default | Producer mới, consumer cũ |
| FULL | Thêm/xóa fields có default | Cả hai hướng compatible |
| NONE | Mọi thay đổi | Dev/testing only |
Mặc định của Confluent Schema Registry là BACKWARD, và nó chỉ so với version liền trước. Muốn so với toàn bộ lịch sử schema thì dùng biến thể BACKWARD_TRANSITIVE, FORWARD_TRANSITIVE, FULL_TRANSITIVE. Với topic giữ data lâu (retention dài hoặc compacted), transitive an toàn hơn vì consumer có thể phải đọc message từ rất nhiều version trước.
# avro schema example
// order-event.avsc
{
  "type": "record",
  "name": "OrderEvent",
  "namespace": "com.example.events",
  "fields": [
    { "name": "orderId", "type": "string" },
    { "name": "userId", "type": "string" },
    { "name": "amount", "type": "double" },
    {
      "name": "status",
      "type": {
        "type": "enum",
        "name": "OrderStatus",
        "symbols": ["CREATED", "CONFIRMED", "SHIPPED", "DELIVERED", "CANCELLED"]
      }
    },
    // logicalType phải nằm TRONG "type", đặt ngang hàng với "name" thì Avro bỏ qua
    { "name": "timestamp", "type": { "type": "long", "logicalType": "timestamp-millis" } },
    // Field mới với default value → backward compatible
    { "name": "currency", "type": "string", "default": "USD" },
    // Optional field
    { "name": "notes", "type": ["null", "string"], "default": null }
  ]
}
# spring boot + schema registry
<!-- pom.xml — thêm dependencies -->
<dependency>
    <groupId>io.confluent</groupId>
    <artifactId>kafka-avro-serializer</artifactId>
    <version>7.5.0</version>
</dependency>
<dependency>
    <groupId>io.confluent</groupId>
    <artifactId>kafka-schema-registry-client</artifactId>
    <version>7.5.0</version>
</dependency>

<!-- Avro Maven Plugin — generate Java classes từ .avsc -->
<plugin>
    <groupId>org.apache.avro</groupId>
    <artifactId>avro-maven-plugin</artifactId>
    <version>1.11.3</version>
    <executions>
        <execution>
            <phase>generate-sources</phase>
            <goals><goal>schema</goal></goals>
            <configuration>
                <sourceDirectory>${project.basedir}/src/main/avro</sourceDirectory>
                <outputDirectory>${project.build.directory}/generated-sources/avro</outputDirectory>
            </configuration>
        </execution>
    </executions>
</plugin>
# application.yml
spring:
kafka:
properties:
schema.registry.url: http://localhost:8081
producer:
key-serializer: org.apache.kafka.common.serialization.StringSerializer
value-serializer: io.confluent.kafka.serializers.KafkaAvroSerializer
consumer:
key-deserializer: org.apache.kafka.common.serialization.StringDeserializer
value-deserializer: io.confluent.kafka.serializers.KafkaAvroDeserializer
properties:
specific.avro.reader: true// Producer với Avro
@Service
public class AvroOrderProducer {
private final KafkaTemplate<String, OrderEvent> kafkaTemplate;
public void publish(OrderEvent event) {
// OrderEvent ở đây là Avro-generated class
kafkaTemplate.send("order-events", event.getOrderId().toString(), event);
}
}
// Consumer với Avro
@Service
public class AvroOrderConsumer {
@KafkaListener(topics = "order-events", groupId = "order-service")
public void handle(OrderEvent event) {
// Avro tự handle schema evolution
// Nếu producer gửi schema v2 nhưng consumer dùng v1,
// Avro sẽ tự map compatible fields
log.info("Order: {} - Amount: {} {}",
event.getOrderId(),
event.getAmount(),
event.getCurrency()); // Default "USD" nếu producer cũ không gửi
}
}# schema registry rest api
# List tất cả subjects
GET http://localhost:8081/subjects

# Lấy latest schema
GET http://localhost:8081/subjects/order-events-value/versions/latest

# Check compatibility trước khi register
POST http://localhost:8081/compatibility/subjects/order-events-value/versions/latest
Content-Type: application/json
{"schema": "{...}"}

# Set compatibility mode
PUT http://localhost:8081/config/order-events-value
Content-Type: application/json
{"compatibility": "BACKWARD"}
# exactly-once semantics (EOS)
EOS là "chén thánh" của distributed messaging. Kafka hỗ trợ từ version 0.11 (2017, KIP-98), nhưng phải hiểu rõ nó chạy thế nào mới dùng đúng.
# ba mức delivery guarantee
At-most-once:  Message có thể mất, nhưng không bao giờ duplicate
               Fire-and-forget. acks=0.
               Use case: Metrics, logs không quan trọng.

At-least-once: Message không mất, nhưng có thể duplicate
               acks=all + retries. Consumer phải idempotent.
               Use case: Hầu hết mọi thứ.

Exactly-once:  Message không mất VÀ không duplicate
               Kafka Transactions + Idempotent Producer.
               Use case: Financial transactions, inventory.
# idempotent producer: nền tảng của EOS
# Bật idempotent producer
spring:
  kafka:
    producer:
      properties:
        enable.idempotence: true
        # Từ Kafka 3.0, idempotence đã bật mặc định (nếu không có config nào xung đột).
        # Idempotence yêu cầu:
        # acks=all
        # retries > 0 (mặc định Integer.MAX_VALUE)
        # max.in.flight.requests.per.connection <= 5 (mặc định 5)
Cách hoạt động:
Producer gửi message với:
  - Producer ID (PID): unique per producer instance
  - Sequence Number: tăng dần per partition

Broker nhận message:
  - Nếu seq = expected → accept
  - Nếu seq < expected → duplicate → không ghi lại, producer vẫn coi là thành công
  - Nếu seq > expected → out of order → reject with error

→ Đảm bảo mỗi message được ghi đúng 1 lần per partition
Cần nhớ phạm vi của nó: idempotence chỉ chống duplicate do retry trong một phiên producer. Producer restart sẽ có PID mới, và nếu ứng dụng tự gọi send() lại lần nữa (ví dụ job chạy lại) thì broker coi đó là message mới. Transaction với transactional.id cố định (phần dưới) xử lý được trường hợp restart: producer mới cùng ID sẽ fence producer cũ và abort transaction đang dở. Còn chuyện ứng dụng tự gửi lại thì vẫn phải chặn ở tầng nghiệp vụ, thường là idempotent consumer.
# kafka transactions: atomic writes across topics/partitions
// KafkaTransactionConfig.java
@Configuration
public class KafkaTransactionConfig {

    @Bean
    public ProducerFactory<String, Object> producerFactory() {
        Map<String, Object> props = new HashMap<>();
        props.put(ProducerConfig.BOOTSTRAP_SERVERS_CONFIG, "localhost:9092");
        props.put(ProducerConfig.KEY_SERIALIZER_CLASS_CONFIG, StringSerializer.class);
        props.put(ProducerConfig.VALUE_SERIALIZER_CLASS_CONFIG, JsonSerializer.class);
        props.put(ProducerConfig.ENABLE_IDEMPOTENCE_CONFIG, true);
        // Transaction ID prefix — mỗi instance cần unique prefix
        props.put(ProducerConfig.TRANSACTIONAL_ID_CONFIG, "order-tx-");

        return new DefaultKafkaProducerFactory<>(props);
    }

    @Bean
    public KafkaTemplate<String, Object> kafkaTemplate() {
        return new KafkaTemplate<>(producerFactory());
    }

    @Bean
    public KafkaTransactionManager<String, Object> kafkaTransactionManager() {
        return new KafkaTransactionManager<>(producerFactory());
    }
}
// Transactional Producer — ghi vào nhiều topics atomically
@Service
public class TransactionalOrderService {
private final KafkaTemplate<String, Object> kafkaTemplate;
/**
* Ghi vào 3 topics trong cùng 1 transaction.
* Hoặc tất cả thành công, hoặc tất cả rollback.
*/
public void processOrder(OrderEvent order) {
kafkaTemplate.executeInTransaction(ops -> {
// 1. Ghi order event
ops.send("order-events", order.getOrderId(), order);
// 2. Ghi payment request
ops.send("payment-requests", order.getOrderId(),
new PaymentRequest(order.getOrderId(), order.getAmount()));
// 3. Ghi audit log
ops.send("audit-log", order.getOrderId(),
new AuditEntry("ORDER_CREATED", order.getOrderId()));
// Nếu bất kỳ send nào fail → tất cả rollback
return true;
});
}
}// Container factory: để container mở Kafka transaction trước khi gọi listener.
// Container sẽ gửi offset của consumer vào chính transaction đó
// (sendOffsetsToTransaction) rồi mới commit.
// Spring Boot: chỉ cần set spring.kafka.producer.transaction-id-prefix,
// Boot tự tạo KafkaTransactionManager và gắn vào container.
@Bean
public ConcurrentKafkaListenerContainerFactory<String, Object> kafkaListenerContainerFactory(
ConsumerFactory<String, Object> cf,
KafkaTransactionManager<String, Object> kafkaTransactionManager) {
ConcurrentKafkaListenerContainerFactory<String, Object> factory =
new ConcurrentKafkaListenerContainerFactory<>();
factory.setConsumerFactory(cf);
// Bản Spring Kafka cũ dùng setTransactionManager(...)
factory.getContainerProperties()
.setKafkaAwareTransactionManager(kafkaTransactionManager);
return factory;
}// Consume-Transform-Produce pattern — EOS end-to-end
@Service
public class ExactlyOnceProcessor {
private final KafkaTemplate<String, Object> kafkaTemplate;
/**
* Đọc từ topic A, transform, ghi vào topic B.
* Consumer offset commit + producer send trong cùng transaction.
*/
@KafkaListener(
topics = "raw-orders",
groupId = "order-processor",
properties = {
"isolation.level=read_committed" // Chỉ đọc committed messages
}
)
// KHÔNG cần @Transactional ở đây: transaction do container mở.
// Nếu chỉ đặt @Transactional("kafkaTransactionManager") mà container không có
// transaction manager, offset sẽ được commit riêng, ngoài transaction → không còn EOS.
public void processAndForward(OrderEvent rawOrder) {
// Transform
EnrichedOrder enriched = enrichOrder(rawOrder);
// Produce (trong cùng transaction với consumer offset commit)
kafkaTemplate.send("enriched-orders", enriched.getOrderId(), enriched);
// Consumer offset tự động commit khi transaction commit
}
}# eos caveats: những điều cần biết
⚠️ EOS chỉ hoạt động trong phạm vi Kafka:
   Kafka → Kafka: Exactly-once ✅
   Kafka → Database: Cần thêm idempotent consumer ở DB side
   Kafka → External API: Không thể exactly-once (dùng at-least-once + idempotency)

⚠️ Performance impact:
   - Overhead phụ thuộc tần suất commit transaction. Benchmark của Confluent
     (1KB message, commit mỗi 100ms) đo được throughput giảm khoảng 3%
     so với at-least-once; commit càng dày thì càng tốn.
   - read_committed consumers có thêm latency (đợi transaction commit)

⚠️ Transactional ID phải unique per producer instance:
   - Dùng hostname hoặc pod name làm suffix
   - Nếu 2 producers cùng transactional.id → producer cũ bị fence
     (ProducerFencedException), không ghi tiếp được
# kafka security
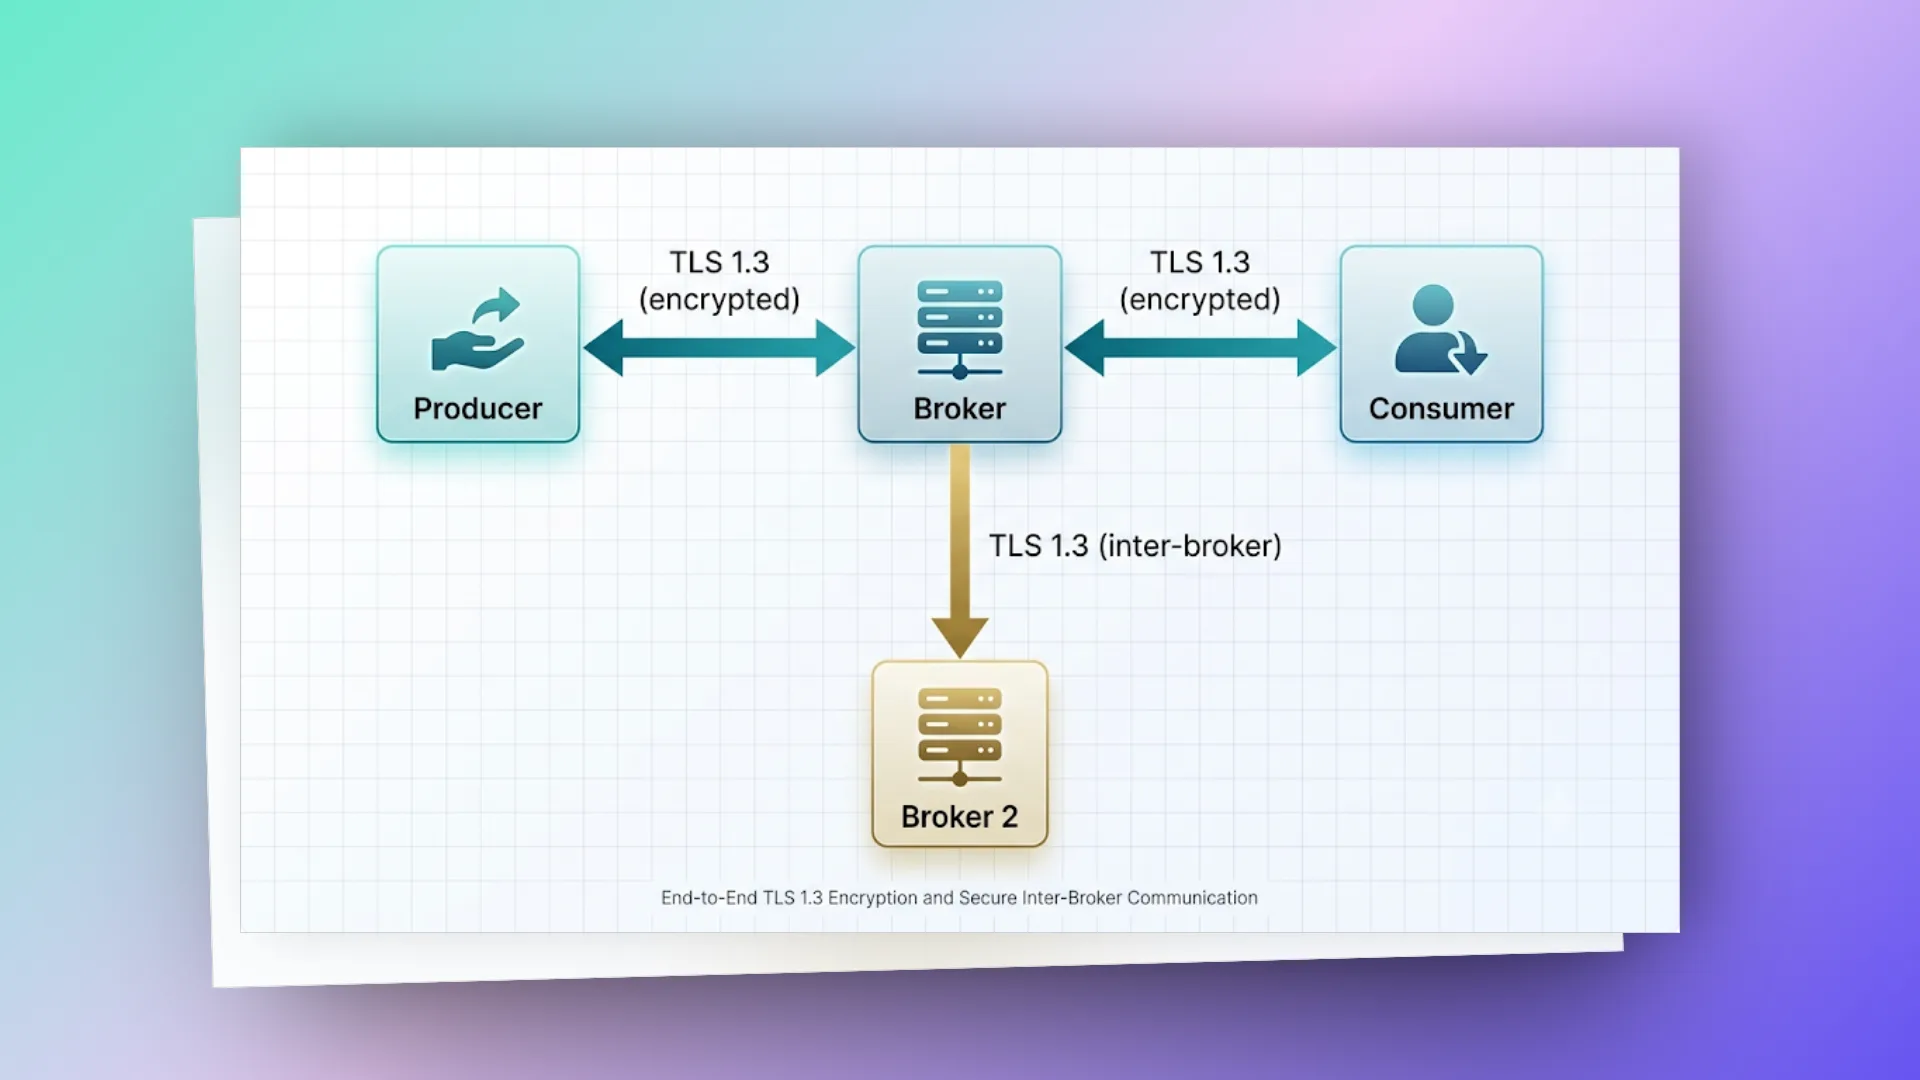
Kafka cluster ở production phải có security, không có ngoại lệ.
# authentication: SASL/SCRAM
# application.yml — Producer/Consumer authentication
spring:
  kafka:
    bootstrap-servers: kafka-1:9093,kafka-2:9093,kafka-3:9093
    properties:
      security.protocol: SASL_SSL
      sasl.mechanism: SCRAM-SHA-512
      sasl.jaas.config: >
        org.apache.kafka.common.security.scram.ScramLoginModule required
        username="${KAFKA_USERNAME}"
        password="${KAFKA_PASSWORD}";
    ssl:
      trust-store-location: classpath:kafka-truststore.jks
      trust-store-password: ${TRUSTSTORE_PASSWORD}
# authentication: mTLS (mutual TLS)
# Cả client và server verify lẫn nhau
spring:
  kafka:
    properties:
      security.protocol: SSL
    ssl:
      key-store-location: classpath:kafka-keystore.jks
      key-store-password: ${KEYSTORE_PASSWORD}
      key-password: ${KEY_PASSWORD}
      trust-store-location: classpath:kafka-truststore.jks
      trust-store-password: ${TRUSTSTORE_PASSWORD}
# authorization: ACLs
# Cho phép user "order-service" đọc/ghi topic "order-events"
kafka-acls --bootstrap-server kafka:9093 \
    --command-config admin.properties \
    --add \
    --allow-principal User:order-service \
    --operation Read --operation Write \
    --topic order-events

# Cho phép consumer group
kafka-acls --bootstrap-server kafka:9093 \
    --command-config admin.properties \
    --add \
    --allow-principal User:order-service \
    --operation Read \
    --group order-service-group

# List ACLs
kafka-acls --bootstrap-server kafka:9093 \
    --command-config admin.properties \
    --list --topic order-events
# encryption in transit: SSL/TLS
# encryption at rest
Kafka không tự mã hoá data nằm trên disk. Có hai hướng:
- Filesystem encryption (dm-crypt, LUKS, hoặc encrypted volume của cloud như EBS encryption), nên dùng. Cách này trong suốt với Kafka, nhưng ai có quyền đọc qua broker vẫn đọc được plaintext.
- Custom Serializer: encrypt ở phía producer trước khi gửi. Broker và người vận hành chỉ thấy ciphertext, đổi lại bạn phải tự lo phân phối và xoay vòng key, còn compression gần như vô dụng vì data đã mã hoá thì không nén được.
// Custom encrypting serializer
public class EncryptingSerializer implements Serializer<Object> {

    private final ObjectMapper mapper = new ObjectMapper();
    // Tạo một lần, dùng lại. SecureRandom.getInstanceStrong() có thể block
    // trên Linux khi entropy thấp, không nên gọi cho từng message.
    private final SecureRandom random = new SecureRandom();
    private SecretKey secretKey;

    @Override
    public void configure(Map<String, ?> configs, boolean isKey) {
        String keyBase64 = (String) configs.get("encryption.key");
        byte[] keyBytes = Base64.getDecoder().decode(keyBase64);
        this.secretKey = new SecretKeySpec(keyBytes, "AES");
    }

    @Override
    public byte[] serialize(String topic, Object data) {
        try {
            byte[] jsonBytes = mapper.writeValueAsBytes(data);
            Cipher cipher = Cipher.getInstance("AES/GCM/NoPadding");
            byte[] iv = new byte[12];
            random.nextBytes(iv); // IV phải mới cho mỗi message với cùng key
            cipher.init(Cipher.ENCRYPT_MODE, secretKey,
                    new GCMParameterSpec(128, iv));
            byte[] encrypted = cipher.doFinal(jsonBytes);

            // [iv_length(1)][iv(12)][encrypted_data]
            ByteBuffer buffer = ByteBuffer.allocate(1 + iv.length + encrypted.length);
            buffer.put((byte) iv.length);
            buffer.put(iv);
            buffer.put(encrypted);
            return buffer.array();
        } catch (Exception e) {
            throw new SerializationException("Encryption failed", e);
        }
    }
}
# kafka transactions
# chaining kafka transaction với database transaction
Trước đây người ta hay dùng ChainedKafkaTransactionManager, nhưng class này đã deprecated từ Spring Kafka 2.7. Cách Spring khuyến nghị bây giờ đơn giản hơn: để transaction DB làm chính, KafkaTemplate (đã cấu hình transactional) tự đồng bộ một Kafka transaction vào đó và commit ngay sau khi DB commit.
@Service
public class OrderServiceWithKafkaTx {

    private final OrderRepository orderRepo;
    // KafkaTemplate có transactionIdPrefix (vd spring.kafka.producer.transaction-id-prefix)
    private final KafkaTemplate<String, Object> kafkaTemplate;

    /**
     * DB save + Kafka publish "đi cùng nhau".
     *
     * Lưu ý: Đây KHÔNG phải 2-phase commit thực sự.
     * Mặc định JPA commit trước, Kafka commit sau.
     * Nếu Kafka commit fail sau khi JPA đã commit → inconsistency.
     * (Muốn Kafka commit trước thì dùng @Transactional lồng nhau:
     *  method ngoài dùng JPA TM, method trong dùng kafkaTransactionManager.)
     *
     * → Vẫn nên dùng Outbox pattern cho critical data.
     */
    @Transactional // JpaTransactionManager
    public void createOrder(OrderEvent event) {
        Order order = new Order(event);
        orderRepo.save(order);
        kafkaTemplate.send("order-events", event.getOrderId(), event);
    }
}
Outbox pattern và idempotent consumer mình có viết riêng ở bài này.
# testing kafka applications
# unit test với MockKafka
@ExtendWith(MockitoExtension.class)
class OrderEventProducerTest {

    @Mock
    private KafkaTemplate<String, OrderEvent> kafkaTemplate;

    @InjectMocks
    private OrderEventProducer producer;

    @Test
    void shouldPublishOrderEvent() {
        // Given
        OrderEvent event = new OrderEvent(
                "order-1", "user-1", "Laptop",
                new BigDecimal("999.99"), OrderEvent.OrderStatus.CREATED);

        CompletableFuture<SendResult<String, OrderEvent>> future =
                CompletableFuture.completedFuture(mockSendResult());
        when(kafkaTemplate.send("order-events", "user-1", event))
                .thenReturn(future);

        // When
        producer.publishOrderEvent(event);

        // Then
        verify(kafkaTemplate).send("order-events", "user-1", event);
    }
}
# integration test với embedded kafka
@SpringBootTest
@EmbeddedKafka(
        partitions = 3,
        topics = {"order-events", "order-events.DLT"},
        // Broker chạy ở port ngẫu nhiên, địa chỉ được gán vào property này
        // để Spring Boot dùng luôn. Tránh hard-code 9092: dễ đụng Kafka local
        // và các test chạy song song.
        bootstrapServersProperty = "spring.kafka.bootstrap-servers"
)
class OrderEventIntegrationTest {

    @Autowired
    private KafkaTemplate<String, OrderEvent> kafkaTemplate;

    @Autowired
    private EmbeddedKafkaBroker embeddedKafka;

    // Spring Boot 3.4+: @MockitoSpyBean (thay cho @SpyBean đã deprecated)
    @MockitoSpyBean
    private OrderEventConsumer consumer;

    @Test
    void shouldProduceAndConsumeOrderEvent() throws Exception {
        // Given
        OrderEvent event = new OrderEvent(
                "order-1", "user-1", "Laptop",
                new BigDecimal("999.99"), OrderEvent.OrderStatus.CREATED);

        // When
        kafkaTemplate.send("order-events", event.getUserId(), event).get();

        // Then — verify consumer received the event
        // Dùng Awaitility vì Kafka consumer là async
        await().atMost(Duration.ofSeconds(10))
                .untilAsserted(() ->
                        verify(consumer).handleOrderEvent(
                                argThat(e -> e.getOrderId().equals("order-1")),
                                anyInt(), anyLong(), anyLong()));
    }

    @Test
    void shouldSendToDeadLetterTopicOnFailure() throws Exception {
        // Given — consumer sẽ throw exception
        doThrow(new RuntimeException("Processing failed"))
                .when(consumer).handleOrderEvent(any(), anyInt(), anyLong(), anyLong());

        OrderEvent event = new OrderEvent(
                "bad-order", "user-1", "Laptop",
                new BigDecimal("999.99"), OrderEvent.OrderStatus.CREATED);

        // When
        kafkaTemplate.send("order-events", event.getUserId(), event).get();

        // Then — verify message ends up in DLT after retries
        Map<String, Object> consumerProps = KafkaTestUtils.consumerProps(
                "test-dlt-group", "true", embeddedKafka);
        consumerProps.put(ConsumerConfig.VALUE_DESERIALIZER_CLASS_CONFIG,
                JsonDeserializer.class); // Spring Kafka 4.x: JacksonJsonDeserializer
        // Mặc định JsonDeserializer chỉ tin vài package của JDK,
        // thiếu dòng này sẽ lỗi khi gặp type header com.example...
        consumerProps.put(JsonDeserializer.TRUSTED_PACKAGES, "*"); // chỉ nên dùng "*" trong test

        Consumer<String, OrderEvent> dltConsumer =
                new DefaultKafkaConsumerFactory<String, OrderEvent>(consumerProps)
                        .createConsumer();
        embeddedKafka.consumeFromAnEmbeddedTopic(dltConsumer, "order-events.DLT");

        ConsumerRecords<String, OrderEvent> records =
                KafkaTestUtils.getRecords(dltConsumer, Duration.ofSeconds(10));

        assertThat(records.count()).isGreaterThan(0);
        assertThat(records.iterator().next().value().getOrderId())
                .isEqualTo("bad-order");
    }
}
# testcontainers: kafka thật trong docker
@SpringBootTest
@Testcontainers
class KafkaTestcontainersTest {

    // org.testcontainers.kafka.KafkaContainer: image apache/kafka, chạy KRaft sẵn.
    // (Class cũ org.testcontainers.containers.KafkaContainer + withKraft() đã deprecated;
    //  muốn dùng image Confluent thì có ConfluentKafkaContainer.)
    @Container
    static KafkaContainer kafka = new KafkaContainer("apache/kafka-native:4.1.0");

    @DynamicPropertySource
    static void kafkaProperties(DynamicPropertyRegistry registry) {
        registry.add("spring.kafka.bootstrap-servers", kafka::getBootstrapServers);
    }

    @Autowired
    private KafkaTemplate<String, OrderEvent> kafkaTemplate;

    @Test
    void shouldWorkWithRealKafka() throws Exception {
        OrderEvent event = new OrderEvent(
                "order-1", "user-1", "Laptop",
                new BigDecimal("999.99"), OrderEvent.OrderStatus.CREATED);

        SendResult<String, OrderEvent> result =
                kafkaTemplate.send("order-events", event.getUserId(), event).get();

        assertThat(result.getRecordMetadata().topic()).isEqualTo("order-events");
        assertThat(result.getRecordMetadata().offset()).isGreaterThanOrEqualTo(0);
    }
}
# consumer test: verify business logic
@SpringBootTest
@EmbeddedKafka(topics = "order-events")
class OrderConsumerBusinessLogicTest {

    @Autowired
    private KafkaTemplate<String, OrderEvent> kafkaTemplate;

    @Autowired
    private OrderRepository orderRepository;

    @Test
    void shouldPersistOrderWhenEventReceived() throws Exception {
        // Given
        OrderEvent event = new OrderEvent(
                "order-42", "user-7", "MacBook Pro",
                new BigDecimal("2499.99"), OrderEvent.OrderStatus.CREATED);

        // When
        kafkaTemplate.send("order-events", event.getUserId(), event).get();

        // Then
        await().atMost(Duration.ofSeconds(10))
                .untilAsserted(() -> {
                    Optional<Order> order = orderRepository.findById("order-42");
                    assertThat(order).isPresent();
                    assertThat(order.get().getStatus()).isEqualTo("CREATED");
                    assertThat(order.get().getAmount())
                            .isEqualByComparingTo(new BigDecimal("2499.99"));
                });
    }
}
# kafka trên kubernetes
# strimzi: kafka operator cho K8s
Từ Strimzi 0.46, ZooKeeper không còn được hỗ trợ (Kafka 4.0 chỉ chạy KRaft). Cluster bây giờ gồm resource Kafka cộng với các KafkaNodePool khai báo node nào làm controller, node nào làm broker. Ví dụ dưới viết theo API v1 của Strimzi 1.2 (hỗ trợ Kafka 4.2.x, 4.3.x); bản Strimzi cũ hơn dùng v1beta2.
# kafka-cluster.yaml — Strimzi CRD (KRaft + node pools)
apiVersion: kafka.strimzi.io/v1
kind: KafkaNodePool
metadata:
  name: controller
  namespace: kafka
  labels:
    strimzi.io/cluster: production-cluster
spec:
  replicas: 3
  roles:
    - controller
  storage:
    type: jbod
    volumes:
      - id: 0
        type: persistent-claim
        size: 20Gi
        class: gp3
        kraftMetadata: shared
---
apiVersion: kafka.strimzi.io/v1
kind: KafkaNodePool
metadata:
  name: broker
  namespace: kafka
  labels:
    strimzi.io/cluster: production-cluster
spec:
  replicas: 3
  roles:
    - broker
  storage:
    type: jbod
    volumes:
      - id: 0
        type: persistent-claim
        size: 100Gi
        class: gp3 # AWS EBS gp3
        kraftMetadata: shared
  resources:
    requests:
      memory: 4Gi
      cpu: '2'
    limits:
      memory: 8Gi
      cpu: '4'
  jvmOptions:
    -Xms: 2048m
    -Xmx: 4096m
---
apiVersion: kafka.strimzi.io/v1
kind: Kafka
metadata:
  name: production-cluster
  namespace: kafka
spec:
  kafka:
    version: 4.3.1 # phải nằm trong danh sách version mà bản Strimzi của bạn hỗ trợ
    listeners:
      - name: plain
        port: 9092
        type: internal
        tls: false
      - name: tls
        port: 9093
        type: internal
        tls: true
        authentication:
          type: scram-sha-512
      - name: external
        port: 9094
        type: loadbalancer
        tls: true
    # Bật authorization thì ACL trong KafkaUser bên dưới mới có hiệu lực
    authorization:
      type: simple
    config:
      offsets.topic.replication.factor: 3
      transaction.state.log.replication.factor: 3
      transaction.state.log.min.isr: 2
      default.replication.factor: 3
      min.insync.replicas: 2
      num.partitions: 6
      log.retention.hours: 168 # 7 ngày
    rack:
      topologyKey: topology.kubernetes.io/zone # Spread across AZs
  entityOperator:
    topicOperator: {}
    userOperator: {}
# strimzi topic & user CRDs
# KafkaTopic CRD — quản lý topics declaratively
apiVersion: kafka.strimzi.io/v1
kind: KafkaTopic
metadata:
  name: order-events
  namespace: kafka
  labels:
    strimzi.io/cluster: production-cluster
spec:
  partitions: 12
  replicas: 3
  config:
    retention.ms: 604800000 # 7 ngày
    min.insync.replicas: 2
    cleanup.policy: delete
    max.message.bytes: 1048576 # 1MB
---
# KafkaUser CRD — quản lý users + ACLs
apiVersion: kafka.strimzi.io/v1
kind: KafkaUser
metadata:
  name: order-service
  namespace: kafka
  labels:
    strimzi.io/cluster: production-cluster
spec:
  authentication:
    type: scram-sha-512
  authorization:
    type: simple
    acls:
      - resource:
          type: topic
          name: order-events
          patternType: literal
        operations: [Read, Write, Describe]
      - resource:
          type: group
          name: order-service
          patternType: prefix
        operations: [Read]
# spring boot deployment trên K8s
# order-service-deployment.yaml
apiVersion: apps/v1
kind: Deployment
metadata:
  name: order-service
spec:
  replicas: 3 # Match hoặc ít hơn số partitions
  selector:
    matchLabels:
      app: order-service
  template:
    metadata:
      labels:
        app: order-service
    spec:
      containers:
        - name: order-service
          image: order-service:latest
          env:
            - name: SPRING_KAFKA_BOOTSTRAP_SERVERS
              # Listener 9093 (TLS + SCRAM) vì app đăng nhập bằng user order-service.
              # Port 9092 (plain) không xác thực, sẽ bị ACL chặn khi bật authorization.
              value: 'production-cluster-kafka-bootstrap.kafka.svc:9093'
            - name: SPRING_KAFKA_CONSUMER_GROUP_ID
              # Dùng cùng group-id cho tất cả replicas
              # Kafka sẽ tự distribute partitions
              value: 'order-service'
            - name: KAFKA_USERNAME
              valueFrom:
                secretKeyRef:
                  name: order-service
                  key: username
            - name: KAFKA_PASSWORD
              valueFrom:
                secretKeyRef:
                  name: order-service
                  key: password
          resources:
            requests:
              memory: 512Mi
              cpu: 250m
            limits:
              memory: 1Gi
              cpu: 500m
          # Liveness probe — app còn sống không
          livenessProbe:
            httpGet:
              path: /actuator/health/liveness
              port: 8080
            initialDelaySeconds: 30
            periodSeconds: 10
          # Readiness probe — app sẵn sàng nhận traffic không
          readinessProbe:
            httpGet:
              path: /actuator/health/readiness
              port: 8080
            initialDelaySeconds: 20
            periodSeconds: 5
      # Graceful shutdown — đợi consumer commit offset
      terminationGracePeriodSeconds: 60
# graceful shutdown: quan trọng trên K8s
// KafkaGracefulShutdown.java
@Configuration
public class KafkaGracefulShutdown {

    @Bean
    public ConcurrentKafkaListenerContainerFactory<String, OrderEvent>
            kafkaListenerContainerFactory(ConsumerFactory<String, OrderEvent> cf) {

        ConcurrentKafkaListenerContainerFactory<String, OrderEvent> factory =
                new ConcurrentKafkaListenerContainerFactory<>();
        factory.setConsumerFactory(cf);

        // Đợi messages đang xử lý hoàn thành trước khi shutdown
        factory.getContainerProperties()
                .setShutdownTimeout(30000L); // 30 giây

        return factory;
    }
}
# application.yml
spring:
lifecycle:
timeout-per-shutdown-phase: 30s
server:
shutdown: graceful# kafka connect với debezium: change data capture
Debezium là CDC platform mã nguồn mở chạy trên Kafka Connect. Khác với JDBC source phải query định kỳ, Debezium đọc thẳng transaction log của database (binlog của MySQL, WAL của PostgreSQL), nên bắt được mọi INSERT/UPDATE/DELETE theo đúng thứ tự commit, kể cả row bị xoá, mà không phải thêm cột updated_at hay tạo tải query lên DB.
# tại sao CDC?
# debezium MySQL connector
{
  "name": "mysql-cdc-connector",
  "config": {
    "connector.class": "io.debezium.connector.mysql.MySqlConnector",
    "database.hostname": "mysql",
    "database.port": "3306",
    "database.user": "debezium",
    "database.password": "${file:/secrets/debezium.properties:password}",
    "database.server.id": "184054",

    "topic.prefix": "cdc",
    "database.include.list": "ecommerce",
    "table.include.list": "ecommerce.orders,ecommerce.order_items",

    "schema.history.internal.kafka.bootstrap.servers": "kafka:9092",
    "schema.history.internal.kafka.topic": "schema-changes.ecommerce",

    "include.schema.changes": "true",
    "transforms": "unwrap",
    "transforms.unwrap.type": "io.debezium.transforms.ExtractNewRecordState",
    "transforms.unwrap.delete.tombstone.handling.mode": "rewrite",
    "transforms.unwrap.add.headers": "op",

    "snapshot.mode": "initial",
    "decimal.handling.mode": "string",
    "time.precision.mode": "connect"
  }
}
# debezium event structure
Đây là event "nguyên bản" Debezium sinh ra, có đủ before, after, source. Với config ở trên, SMT ExtractNewRecordState sẽ làm phẳng nó: message trong topic chỉ còn nội dung của after, loại thao tác được đưa vào header __op (nhờ add.headers: op), còn event DELETE được giữ lại với field __deleted: "true" (nhờ rewrite). Hai option delete.handling.mode và drop.tombstones mà nhiều bài cũ hay dùng đã deprecated từ Debezium 2.5 và bị bỏ ở 3.2.
// Topic: cdc.ecommerce.orders
// Khi INSERT
{
  "before": null,
  "after": {
    "id": 1001,
    "user_id": "user-42",
    "amount": "299.99",
    "status": "CREATED",
    "created_at": 1698765432000
  },
  "source": {
    "version": "2.4.0",
    "connector": "mysql",
    "name": "cdc",
    "ts_ms": 1698765432000,
    "db": "ecommerce",
    "table": "orders",
    "server_id": 184054,
    "file": "mysql-bin.000003",
    "pos": 1234
  },
  "op": "c", // c=create, u=update, d=delete, r=read(snapshot)
  "ts_ms": 1698765432100
}
# consumer cho CDC events
@Service
@Slf4j
public class CdcOrderConsumer {

    @KafkaListener(topics = "cdc.ecommerce.orders", groupId = "search-indexer")
    public void handleCdcEvent(
            @Payload String payload,
            @Header("__op") String operation) {

        switch (operation) {
            case "c", "r" -> {
                // Create hoặc Snapshot read → index document
                OrderDocument doc = parseOrder(payload);
                elasticsearchClient.index(doc);
                log.info("Indexed order: {}", doc.getId());
            }
            case "u" -> {
                // Update → update document
                OrderDocument doc = parseOrder(payload);
                elasticsearchClient.update(doc);
                log.info("Updated order: {}", doc.getId());
            }
            case "d" -> {
                // Delete → remove document
                String orderId = parseOrderId(payload);
                elasticsearchClient.delete(orderId);
                log.info("Deleted order: {}", orderId);
            }
        }
    }
}
# kafka headers & interceptors
# custom headers cho distributed tracing
// TracingProducerInterceptor.java — tự động inject trace headers
public class TracingProducerInterceptor
        implements ProducerInterceptor<String, Object> {

    @Override
    public ProducerRecord<String, Object> onSend(
            ProducerRecord<String, Object> record) {

        // Inject trace context vào headers
        // Span.current() của OpenTelemetry không bao giờ null:
        // không có span thì nó trả về span "invalid", nên phải check isValid()
        SpanContext ctx = Span.current().getSpanContext();
        if (ctx.isValid()) {
            record.headers()
                    .add("traceId", ctx.getTraceId().getBytes(UTF_8))
                    .add("spanId", ctx.getSpanId().getBytes(UTF_8))
                    .add("producedAt",
                            String.valueOf(System.currentTimeMillis()).getBytes(UTF_8))
                    .add("producerService", "order-service".getBytes(UTF_8));
        }
        return record;
    }

    @Override
    public void onAcknowledgement(RecordMetadata metadata, Exception exception) {
        if (exception != null) {
            // Metric: kafka_producer_errors_total
            Metrics.counter("kafka.producer.errors").increment();
        }
    }

    @Override public void close() {}
    @Override public void configure(Map<String, ?> configs) {}
}
// TracingConsumerInterceptor.java — extract trace headers
public class TracingConsumerInterceptor
implements ConsumerInterceptor<String, Object> {
@Override
public ConsumerRecords<String, Object> onConsume(
ConsumerRecords<String, Object> records) {
// onConsume chạy MỘT lần cho cả batch vừa poll về, TRƯỚC khi xử lý record nào.
// Đừng MDC.put("traceId", ...) ở đây: mọi record trong batch sẽ dính traceId
// của record cuối. Gắn MDC theo từng record thì dùng RecordInterceptor (bên dưới).
records.forEach(record -> {
Header producedAtHeader = record.headers().lastHeader("producedAt");
if (producedAtHeader != null) {
long producedAt = Long.parseLong(
new String(producedAtHeader.value(), UTF_8));
long lag = System.currentTimeMillis() - producedAt;
// Metric: thời gian từ produce đến consume
// (dựa vào đồng hồ của 2 máy khác nhau, lệch giờ sẽ làm sai số)
Metrics.timer("kafka.consumer.e2e.latency")
.record(lag, TimeUnit.MILLISECONDS);
}
});
return records;
}
@Override public void onCommit(Map<TopicPartition, OffsetAndMetadata> offsets) {}
@Override public void close() {}
@Override public void configure(Map<String, ?> configs) {}
}// Spring Kafka: RecordInterceptor chạy cho TỪNG record, ngay trước listener
@Bean
public RecordInterceptor<String, Object> mdcRecordInterceptor() {
return new RecordInterceptor<>() {
@Override
public ConsumerRecord<String, Object> intercept(
ConsumerRecord<String, Object> record, Consumer<String, Object> consumer) {
Header h = record.headers().lastHeader("traceId");
if (h != null) {
MDC.put("traceId", new String(h.value(), UTF_8));
}
return record;
}
@Override
public void afterRecord(
ConsumerRecord<String, Object> record, Consumer<String, Object> consumer) {
MDC.remove("traceId"); // dọn để record sau không dính traceId cũ
}
};
}
// Gắn vào container: factory.setRecordInterceptor(mdcRecordInterceptor())Ví dụ trên tự đặt tên header cho dễ hiểu. Ở dự án thật, nếu đã dùng Micrometer Tracing hoặc OpenTelemetry thì chỉ cần bật observation cho Kafka (Spring Kafka có observationEnabled cho template và container, Spring Boot có property spring.kafka.template.observation-enabled và spring.kafka.listener.observation-enabled). Trace context sẽ được truyền qua header chuẩn W3C traceparent, tương thích với các service viết bằng ngôn ngữ khác.
# Đăng ký interceptors
spring:
  kafka:
    producer:
      properties:
        interceptor.classes: com.example.TracingProducerInterceptor
    consumer:
      properties:
        interceptor.classes: com.example.TracingConsumerInterceptor
# custom header filter strategy
// Lọc message dựa trên header: bỏ qua message đã retry quá nhiều lần
@Configuration
public class KafkaHeaderConfig {

    @Bean
    public ConcurrentKafkaListenerContainerFactory<String, Object>
            filteredHeaderFactory(ConsumerFactory<String, Object> cf) {

        ConcurrentKafkaListenerContainerFactory<String, Object> factory =
                new ConcurrentKafkaListenerContainerFactory<>();
        factory.setConsumerFactory(cf);

        // RecordFilterStrategy: trả về true = BỎ message đó, listener không được gọi
        factory.setRecordFilterStrategy(record -> {
            Header retryCount = record.headers().lastHeader("x-retry-count");
            if (retryCount != null) {
                int count = Integer.parseInt(
                        new String(retryCount.value(), UTF_8));
                return count > 5; // Filter out messages đã retry quá 5 lần
            }
            return false;
        });

        return factory;
    }
}
# operational playbook
# kafka CLI commands bạn cần biết
Tên lệnh dưới đây theo kiểu Confluent Platform (kafka-topics). Với bản Apache Kafka tải từ kafka.apache.org thì các script nằm trong bin/ và có đuôi .sh (bin/kafka-topics.sh), tham số giống nhau.
# ===== TOPIC MANAGEMENT =====

# List topics
kafka-topics --bootstrap-server localhost:9092 --list

# Describe topic (xem partitions, replicas, ISR)
kafka-topics --bootstrap-server localhost:9092 \
    --describe --topic order-events

# Tạo topic
kafka-topics --bootstrap-server localhost:9092 \
    --create --topic order-events \
    --partitions 12 --replication-factor 3

# Tăng partitions (KHÔNG THỂ GIẢM)
kafka-topics --bootstrap-server localhost:9092 \
    --alter --topic order-events --partitions 24

# Xóa topic
kafka-topics --bootstrap-server localhost:9092 \
    --delete --topic order-events


# ===== CONSUMER GROUP MANAGEMENT =====

# List consumer groups
kafka-consumer-groups --bootstrap-server localhost:9092 --list

# Describe group (xem lag, assigned partitions)
kafka-consumer-groups --bootstrap-server localhost:9092 \
    --describe --group order-service

# Output:
# TOPIC          PARTITION  CURRENT-OFFSET  LOG-END-OFFSET  LAG
# order-events   0          1847            1850            3
# order-events   1          2103            2103            0
# order-events   2          1956            1960            4

# Reset offset về earliest (consumer group phải STOPPED)
kafka-consumer-groups --bootstrap-server localhost:9092 \
    --group order-service \
    --topic order-events \
    --reset-offsets --to-earliest \
    --execute

# Reset offset về specific timestamp
kafka-consumer-groups --bootstrap-server localhost:9092 \
    --group order-service \
    --topic order-events \
    --reset-offsets --to-datetime "2024-01-15T00:00:00.000" \
    --execute

# Reset offset shift by -100 (đọc lại 100 messages)
kafka-consumer-groups --bootstrap-server localhost:9092 \
    --group order-service \
    --topic order-events \
    --reset-offsets --shift-by -100 \
    --execute


# ===== PRODUCE & CONSUME (Debug) =====

# Produce test message
# Dòng có dạng <key>|<value>. Đừng dùng ":" làm separator vì JSON cũng có ":"
echo 'test-1|{"orderId":"test-1","status":"CREATED"}' | \
kafka-console-producer --bootstrap-server localhost:9092 \
    --topic order-events \
    --property "key.separator=|" \
    --property "parse.key=true"

# Consume từ beginning
kafka-console-consumer --bootstrap-server localhost:9092 \
    --topic order-events \
    --from-beginning \
    --max-messages 10 \
    --property print.key=true \
    --property print.timestamp=true \
    --property print.partition=true


# ===== CLUSTER HEALTH =====

# Trạng thái KRaft controller quorum (leader, voters, độ trễ replicate metadata)
kafka-metadata-quorum --bootstrap-server localhost:9092 describe --status

# Liệt kê broker đang sống
kafka-broker-api-versions --bootstrap-server localhost:9092 | grep "id:"

# Check under-replicated partitions
kafka-topics --bootstrap-server localhost:9092 \
    --describe --under-replicated-partitions

# Check unavailable partitions
kafka-topics --bootstrap-server localhost:9092 \
    --describe --unavailable-partitions
# partition reassignment: rebalance data giữa brokers
# Khi thêm broker mới, data không tự động move.
# Bạn cần reassign partitions manually.

# 1. Generate reassignment plan
kafka-reassign-partitions --bootstrap-server localhost:9092 \
    --topics-to-move-json-file topics.json \
    --broker-list "0,1,2,3" \
    --generate

# topics.json:
# {"topics": [{"topic": "order-events"}], "version": 1}

# 2. Execute reassignment
kafka-reassign-partitions --bootstrap-server localhost:9092 \
    --reassignment-json-file reassignment.json \
    --execute \
    --throttle 50000000  # 50MB/s — tránh overload network

# 3. Verify completion
kafka-reassign-partitions --bootstrap-server localhost:9092 \
    --reassignment-json-file reassignment.json \
    --verify
# monitoring dashboard: metrics quan trọng nhất
# prometheus + grafana setup
# docker-compose monitoring stack
services:
  kafka-exporter:
    image: danielqsj/kafka-exporter:latest
    command:
      - '--kafka.server=kafka-1:9092'
      - '--kafka.server=kafka-2:9092'
      - '--kafka.server=kafka-3:9092'
    ports:
      - '9308:9308'

  # JMX exporter KHÔNG phải service riêng: nó chạy như Java agent trong từng broker.
  # Thêm vào KAFKA_OPTS của broker:
  # -javaagent:/opt/jmx-exporter/jmx_prometheus_javaagent.jar=7071:/opt/jmx-exporter/kafka-broker.yml

  prometheus:
    image: prom/prometheus:latest
    volumes:
      - ./prometheus.yml:/etc/prometheus/prometheus.yml
    ports:
      - '9090:9090'

  grafana:
    image: grafana/grafana:latest
    ports:
      - '3000:3000'
    environment:
      GF_SECURITY_ADMIN_PASSWORD: admin
# prometheus.yml
scrape_configs:
- job_name: 'kafka-exporter'
static_configs:
- targets: ['kafka-exporter:9308']
scrape_interval: 15s
- job_name: 'kafka-jmx'
static_configs:
- targets:
- 'kafka-1:7071'
- 'kafka-2:7071'
- 'kafka-3:7071'
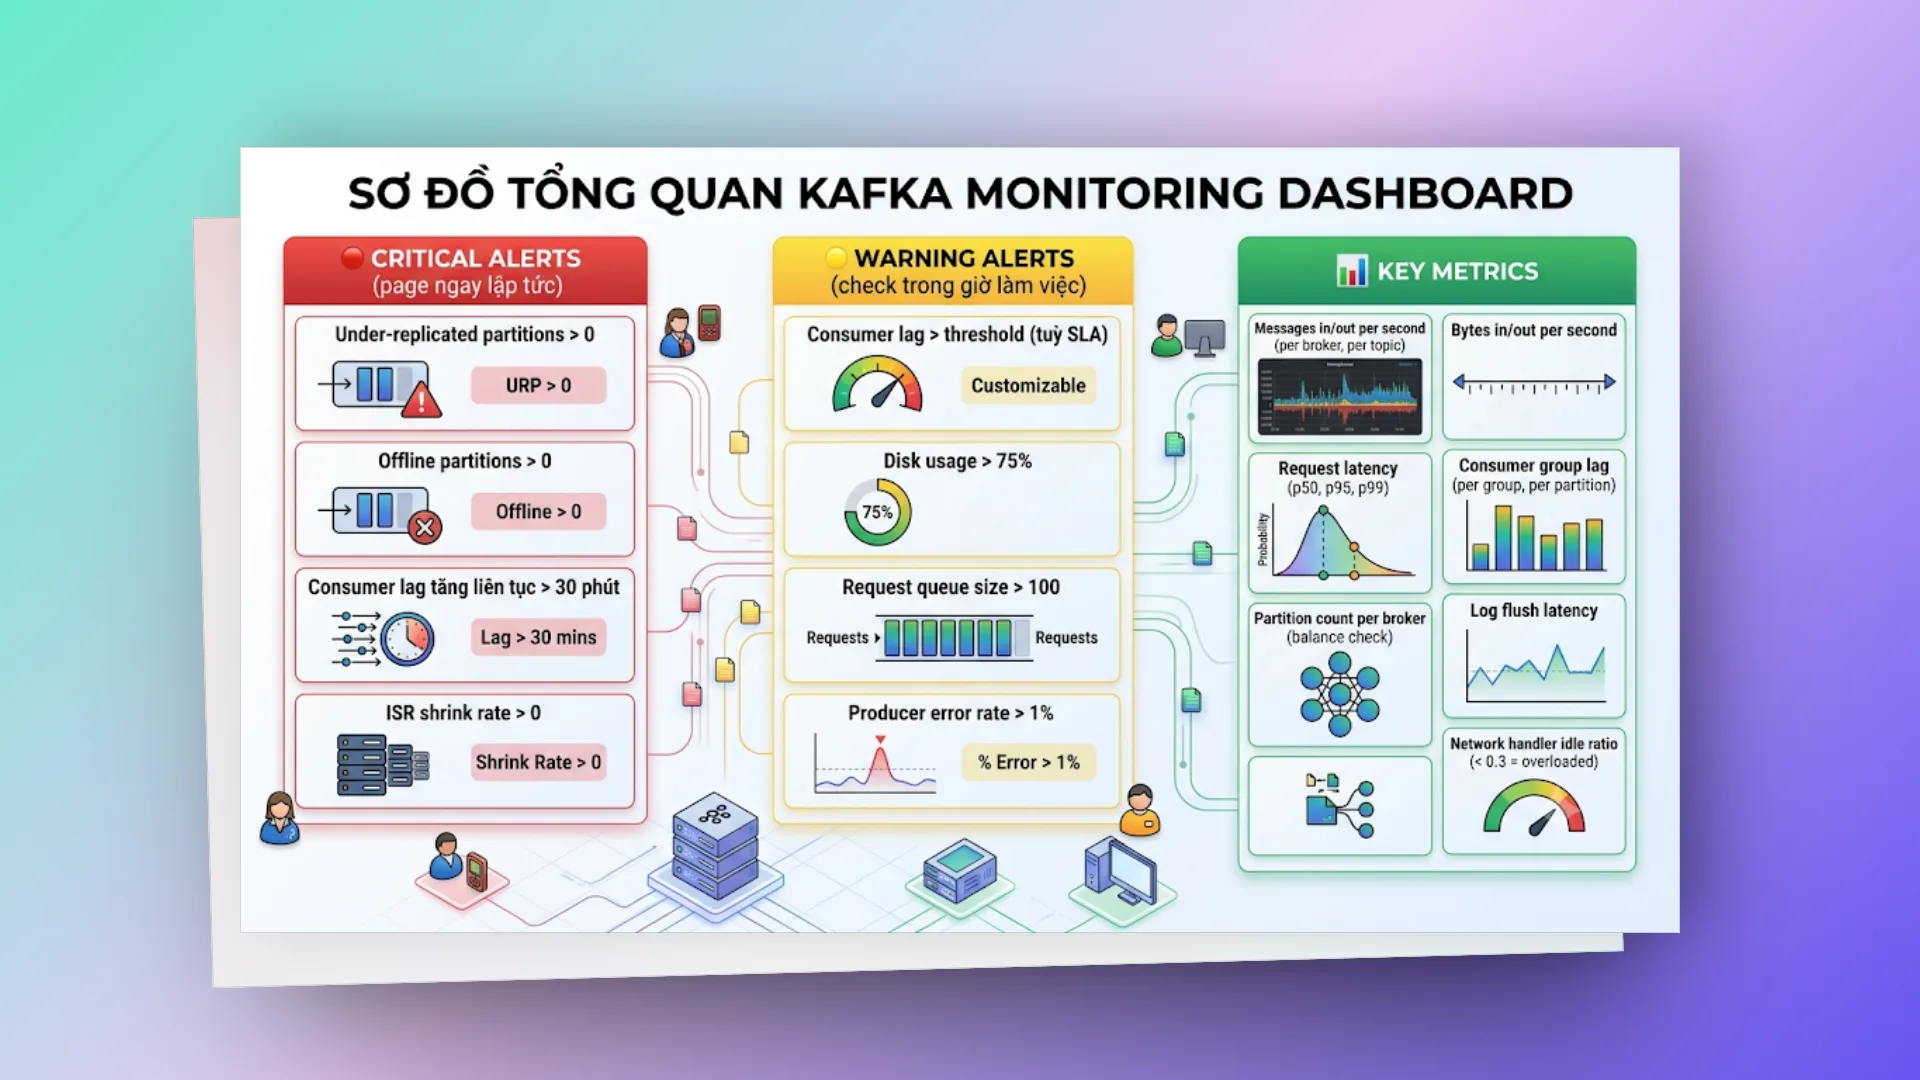
scrape_interval: 15s# alerting rules
# prometheus-alerts.yml
groups:
  - name: kafka-alerts
    rules:
      - alert: KafkaUnderReplicatedPartitions
        expr: kafka_server_replica_manager_under_replicated_partitions > 0
        for: 5m
        labels:
          severity: critical
        annotations:
          summary: 'Kafka has under-replicated partitions'
          description: 'Broker {{ $labels.instance }} has {{ $value }} under-replicated partitions'

      - alert: KafkaConsumerLagHigh
        expr: kafka_consumergroup_lag_sum > 10000
        for: 15m
        labels:
          severity: warning
        annotations:
          summary: 'Consumer group {{ $labels.consumergroup }} lag is high'
          description: 'Lag: {{ $value }} messages on topic {{ $labels.topic }}'

      - alert: KafkaBrokerDiskUsageHigh
        expr: (1 - node_filesystem_avail_bytes{mountpoint="/kafka-data"} / node_filesystem_size_bytes{mountpoint="/kafka-data"}) > 0.75
        for: 10m
        labels:
          severity: warning
        annotations:
          summary: 'Kafka broker disk usage > 75%'

      - alert: KafkaOfflinePartitions
        expr: kafka_controller_kafkacontroller_offline_partitions_count > 0
        for: 1m
        labels:
          severity: critical
        annotations:
          summary: 'Kafka has offline partitions — DATA UNAVAILABLE'
# incident playbook: khi mọi thứ cháy
# scenario 1: consumer lag tăng không dừng
Triệu chứng: Consumer lag tăng liên tục, messages pile up.

Checklist:
1. Consumer còn running không?
   → kafka-consumer-groups --describe --group <group>
   → Nếu STATE = Empty → consumer đã chết

2. Consumer đang rebalance liên tục?
   → Check logs: "Revoking previously assigned partitions"
   → Tăng max.poll.interval.ms hoặc giảm max.poll.records

3. Processing quá chậm?
   → Check processing time per message
   → Scale up: thêm consumer instances (≤ số partitions)
   → Hoặc tăng partitions + consumers

4. Spike traffic?
   → Tạm thời tăng max.poll.records
   → Batch processing thay vì single message

Quick fix:
  # Scale consumers lên bằng số partitions
  kubectl scale deployment order-service --replicas=12
# scenario 2: broker chết
Triệu chứng: 1 broker offline, under-replicated partitions xuất hiện.

Checklist:
1. Check broker status
   → kafka-broker-api-versions --bootstrap-server <broker> (broker nào còn trả lời)
   → kafka-metadata-quorum --bootstrap-server <broker> describe --status

2. Nếu broker restart được:
   → Restart broker
   → Đợi ISR sync lại (check under-replicated = 0)

3. Nếu broker không restart được (disk failure):
   → Kafka tự elect new leaders cho affected partitions
   → Replace broker hardware
   → Reassign partitions nếu cần

4. Nếu min.insync.replicas không đủ:
   → Producer dùng acks=all sẽ nhận NotEnoughReplicasException
     (lỗi retriable: producer retry tới hết delivery.timeout.ms rồi fail)
   → Tạm thời giảm min.insync.replicas (NGUY HIỂM)
   → Hoặc fix broker ASAP
# scenario 3: disk full
Triệu chứng: Broker log "No space left on device"

Emergency fix:
1. Giảm retention tạm thời
   kafka-configs --bootstrap-server localhost:9092 \
       --alter --entity-type topics --entity-name bulky-topic \
       --add-config retention.ms=3600000  # 1 giờ

2. Đợi broker dọn segment cũ
   # Retention được check định kỳ theo log.retention.check.interval.ms (mặc định 5 phút).
   # Chỉ segment đã đóng mới bị xoá. Nếu topic đang là cleanup.policy=compact
   # thì retention.ms không xoá data cũ; cân nhắc chuyển sang compact,delete.
   kafka-configs --bootstrap-server localhost:9092 \
       --describe --entity-type topics --entity-name bulky-topic

3. Xóa old segments manually (LAST RESORT)
   # Chỉ xóa segments đã closed (không phải active segment)

Prevention:
  - Monitor disk usage
  - Set retention policy hợp lý
  - Dùng tiered storage (early access từ Kafka 3.6, production-ready từ 3.9)
# advanced patterns
# pattern: claim check: khi message quá lớn
Kafka có giới hạn message size (mặc định khoảng 1MB, gồm message.max.bytes ở broker và max.request.size ở producer). Tăng giới hạn thì được, nhưng message to làm broker tốn memory, replicate chậm và consumer dễ timeout. Khi cần gửi data lớn, cách hay dùng là claim check: để payload ở object storage, Kafka chỉ chở cái "phiếu gửi đồ":
// Thay vì gửi file 50MB qua Kafka:
// 1. Upload file lên S3
// 2. Gửi reference (claim check) qua Kafka

@Service
public class ClaimCheckProducer {

    private final S3Client s3Client;
    private final KafkaTemplate<String, ClaimCheckEvent> kafkaTemplate;

    public void publishLargePayload(String key, byte[] largePayload) {
        // 1. Store payload in S3
        String s3Key = "kafka-payloads/" + UUID.randomUUID();
        s3Client.putObject(
                PutObjectRequest.builder()
                        .bucket("kafka-large-messages")
                        .key(s3Key)
                        .build(),
                RequestBody.fromBytes(largePayload));

        // 2. Send claim check to Kafka
        ClaimCheckEvent event = new ClaimCheckEvent(
                s3Key,
                largePayload.length,
                "s3://kafka-large-messages/" + s3Key
        );
        kafkaTemplate.send("large-events", key, event);
    }
}

// Consumer retrieves from S3
@Service
public class ClaimCheckConsumer {

    private final S3Client s3Client;

    @KafkaListener(topics = "large-events", groupId = "processor")
    public void handle(ClaimCheckEvent event) {
        // Fetch actual payload from S3
        byte[] payload = s3Client.getObjectAsBytes(
                GetObjectRequest.builder()
                        .bucket("kafka-large-messages")
                        .key(event.getS3Key())
                        .build()
        ).asByteArray();

        processLargePayload(payload);
    }
}
# pattern: priority queue với multiple topics
Kafka không có priority queue sẵn: trong một partition, message luôn được đọc theo thứ tự offset. Workaround hay gặp là tách topic theo mức ưu tiên:
// Tạo topics theo priority level
// order-events-high
// order-events-medium
// order-events-low

@Service
public class PriorityProducer {

    private final KafkaTemplate<String, OrderEvent> kafkaTemplate;

    public void publish(OrderEvent event, Priority priority) {
        String topic = switch (priority) {
            case HIGH   -> "order-events-high";
            case MEDIUM -> "order-events-medium";
            case LOW    -> "order-events-low";
        };
        kafkaTemplate.send(topic, event.getOrderId(), event);
    }
}

// Lưu ý: đây KHÔNG phải ưu tiên thật. Ba listener chạy song song, độc lập;
// high chỉ được nhiều consumer hơn nên thông lượng cao hơn.
// concurrency lớn hơn số partition của topic thì phần dư ngồi chơi.
@Service
public class PriorityConsumer {

    // High priority — nhiều consumers hơn
    @KafkaListener(topics = "order-events-high",
            groupId = "order-processor", concurrency = "6")
    public void handleHigh(OrderEvent event) {
        processOrder(event);
    }

    // Medium priority
    @KafkaListener(topics = "order-events-medium",
            groupId = "order-processor", concurrency = "3")
    public void handleMedium(OrderEvent event) {
        processOrder(event);
    }

    // Low priority — ít consumers
    @KafkaListener(topics = "order-events-low",
            groupId = "order-processor", concurrency = "1")
    public void handleLow(OrderEvent event) {
        processOrder(event);
    }
}
# pattern: scheduled/delayed messages
Kafka không hỗ trợ delayed delivery sẵn. Một cách làm thô sơ:
@Service
public class DelayedMessageProcessor {

    private final KafkaTemplate<String, DelayedEvent> kafkaTemplate;

    // Producer: gửi message với scheduled time
    public void scheduleEvent(OrderEvent event, Duration delay) {
        DelayedEvent delayed = new DelayedEvent(
                event,
                Instant.now().plus(delay).toEpochMilli()
        );
        kafkaTemplate.send("delayed-events", event.getOrderId(), delayed);
    }

    // Consumer: check nếu đến giờ thì xử lý, chưa thì gửi lại
    @KafkaListener(topics = "delayed-events", groupId = "delay-processor")
    public void handleDelayed(DelayedEvent event) {
        long now = System.currentTimeMillis();

        if (now >= event.getScheduledAt()) {
            // Đến giờ → forward sang topic chính
            kafkaTemplate.send("order-events",
                    event.getPayload().getOrderId(),
                    event.getPayload());
        } else {
            // Chưa đến giờ → gửi lại vào delayed topic
            // ⚠️ Cẩn thận: approach này tạo loop, cần rate limiting.
            // ⚠️ sleep trong listener cộng dồn theo batch: 500 record (max.poll.records
            //    mặc định) x 5s vượt xa max.poll.interval.ms (mặc định 5 phút)
            //    → consumer bị đá khỏi group, rebalance liên tục.
            long sleepMs = Math.min(
                    event.getScheduledAt() - now,
                    5000L  // Max sleep 5 giây
            );
            try {
                Thread.sleep(sleepMs);
            } catch (InterruptedException e) {
                Thread.currentThread().interrupt();
            }
            kafkaTemplate.send("delayed-events",
                    event.getPayload().getOrderId(), event);
        }
    }
}
💡 Better approach: Dùng database (Redis sorted set hoặc DB table) làm delay buffer, scheduler poll và publish khi đến giờ. Tránh Kafka loop.
# pattern: request-reply với kafka
// Config ReplyingKafkaTemplate
@Configuration
public class RequestReplyConfig {

    @Bean
    public ReplyingKafkaTemplate<String, OrderRequest, OrderResponse>
            replyingTemplate(
                    ProducerFactory<String, OrderRequest> pf,
                    ConcurrentMessageListenerContainer<String, OrderResponse> container) {

        ReplyingKafkaTemplate<String, OrderRequest, OrderResponse> template =
                new ReplyingKafkaTemplate<>(pf, container);
        template.setDefaultReplyTimeout(Duration.ofSeconds(10));
        return template;
    }

    @Bean
    public ConcurrentMessageListenerContainer<String, OrderResponse>
            replyContainer(ConsumerFactory<String, OrderResponse> cf) {

        ContainerProperties props = new ContainerProperties("order-replies");
        return new ConcurrentMessageListenerContainer<>(cf, props);
    }
}

// Client — gửi request và đợi reply
@Service
public class OrderClient {

    private final ReplyingKafkaTemplate<String, OrderRequest, OrderResponse>
            replyingTemplate;

    public OrderResponse getOrderStatus(String orderId) throws Exception {
        ProducerRecord<String, OrderRequest> record =
                new ProducerRecord<>("order-requests", orderId,
                        new OrderRequest(orderId, "GET_STATUS"));

        // ReplyingKafkaTemplate (của Spring) tự gắn header reply topic + correlation id
        RequestReplyFuture<String, OrderRequest, OrderResponse> future =
                replyingTemplate.sendAndReceive(record);

        // Block và đợi reply (có timeout)
        ConsumerRecord<String, OrderResponse> response =
                future.get(10, TimeUnit.SECONDS);

        return response.value();
    }
}

// Server — xử lý request và gửi reply
@Service
public class OrderRequestHandler {

    @KafkaListener(topics = "order-requests", groupId = "order-handler")
    @SendTo  // Tự động reply về topic trong header
    public OrderResponse handleRequest(OrderRequest request) {
        return switch (request.getAction()) {
            case "GET_STATUS" -> new OrderResponse(
                    request.getOrderId(),
                    orderService.getStatus(request.getOrderId()));
            default -> new OrderResponse(
                    request.getOrderId(), "UNKNOWN_ACTION");
        };
    }
}
# KRaft mode: kafka không cần zookeeper
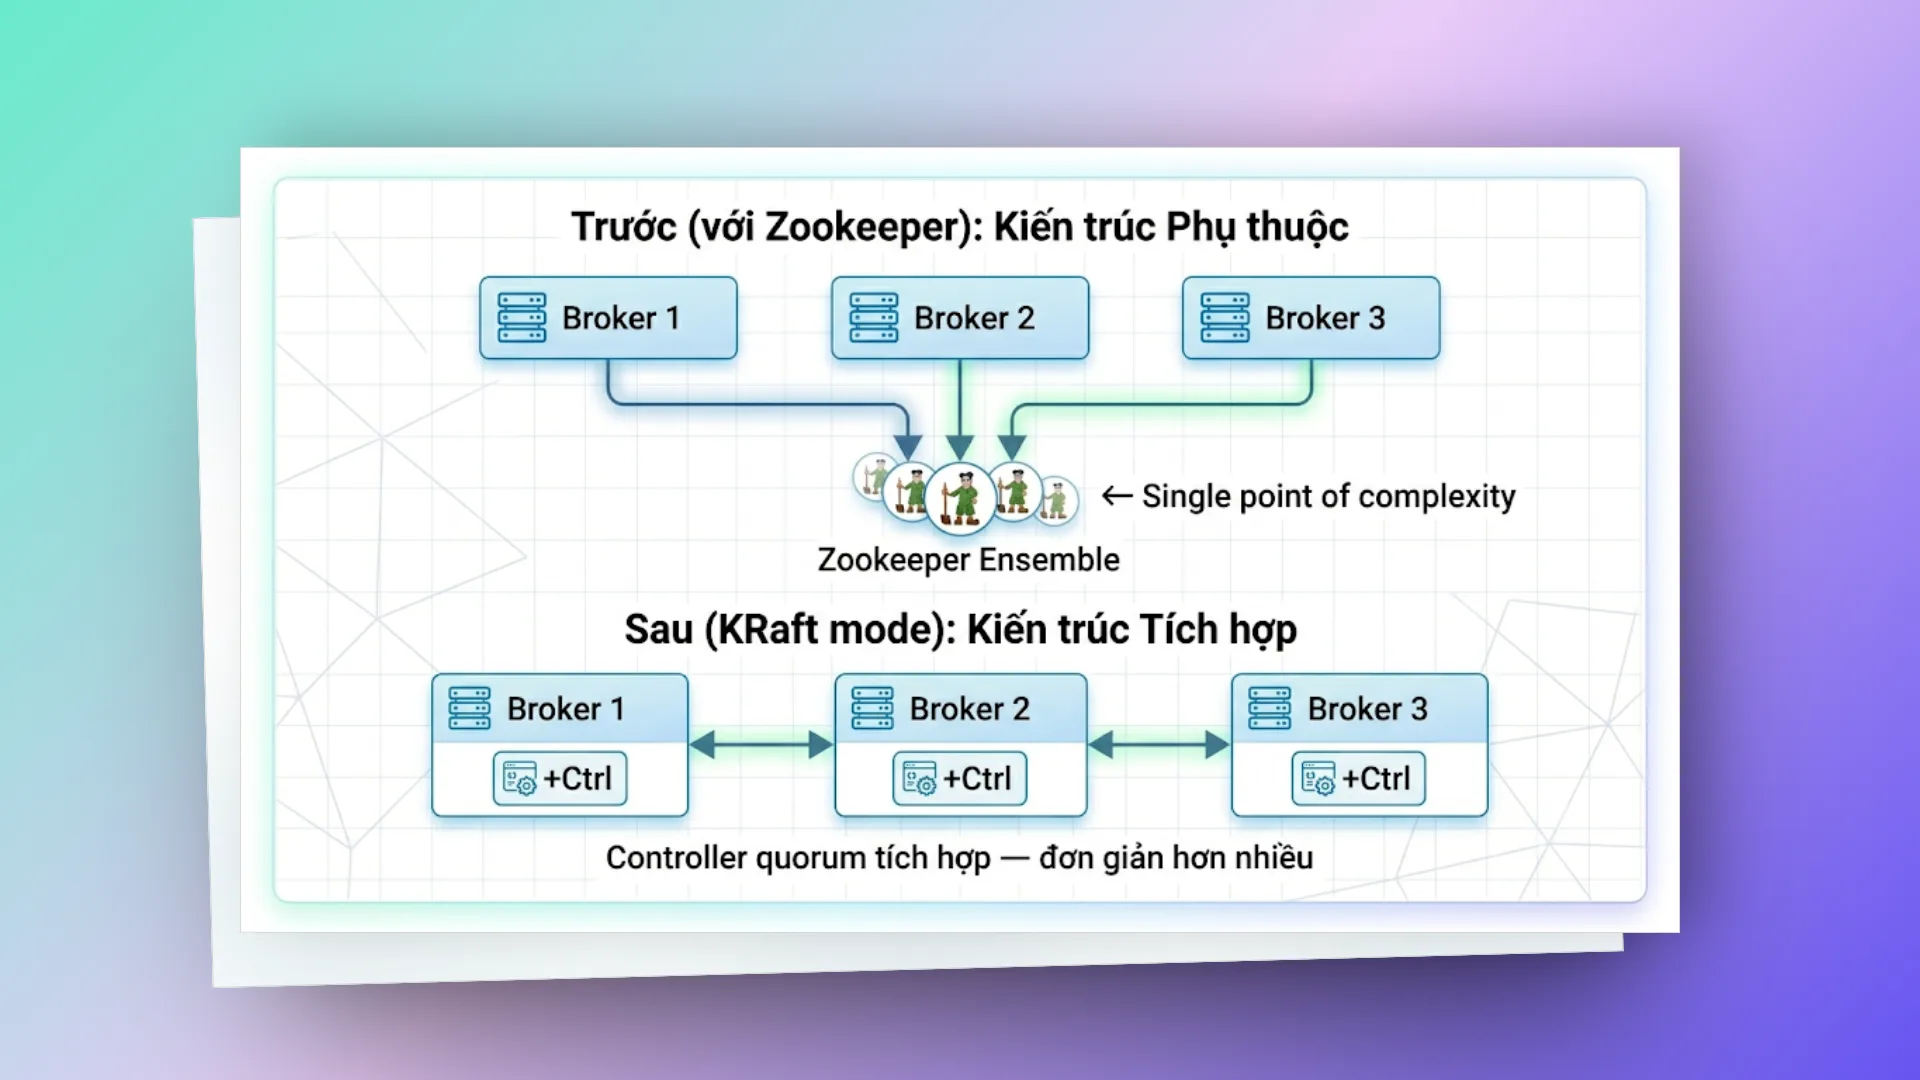
KRaft mode cho phép chạy Kafka mà không cần ZooKeeper, và được công bố production-ready từ Kafka 3.3. Kafka 4.0 (phát hành tháng 3/2025) đã bỏ hẳn ZooKeeper, nên cluster mới bây giờ chỉ có KRaft. Metadata của cluster được lưu trong một topic nội bộ, replicate giữa các controller bằng giao thức Raft, thay vì nằm ở một hệ thống ZooKeeper riêng phải vận hành song song.
# docker-compose KRaft mode
services:
  kafka:
    image: apache/kafka:4.1.0
    ports:
      - '9092:9092'
    environment:
      KAFKA_NODE_ID: 1
      KAFKA_PROCESS_ROLES: broker,controller
      KAFKA_LISTENERS: PLAINTEXT://0.0.0.0:9092,CONTROLLER://0.0.0.0:9093
      KAFKA_ADVERTISED_LISTENERS: PLAINTEXT://localhost:9092
      KAFKA_CONTROLLER_LISTENER_NAMES: CONTROLLER
      KAFKA_LISTENER_SECURITY_PROTOCOL_MAP: CONTROLLER:PLAINTEXT,PLAINTEXT:PLAINTEXT
      KAFKA_CONTROLLER_QUORUM_VOTERS: 1@kafka:9093
      KAFKA_OFFSETS_TOPIC_REPLICATION_FACTOR: 1
      CLUSTER_ID: 'MkU3OEVBNTcwNTJENDM2Qk'
# performance benchmarking
# Producer benchmark
kafka-producer-perf-test \
    --topic perf-test \
    --num-records 1000000 \
    --record-size 1024 \
    --throughput -1 \
    --producer-props \
        bootstrap.servers=localhost:9092 \
        acks=all \
        linger.ms=5 \
        batch.size=65536 \
        compression.type=lz4

# Output (số liệu minh hoạ, tuỳ phần cứng; bản mới in thêm p50/p95/p99):
# 1000000 records sent, 285714.3 records/sec (278.89 MB/sec),
# 3.2 ms avg latency, 87.0 ms max latency

# Consumer benchmark
kafka-consumer-perf-test \
    --bootstrap-server localhost:9092 \
    --topic perf-test \
    --messages 1000000

# Output (rút gọn; bản mới có thêm cột rebalance.time.ms, fetch.*):
# start.time, end.time, data.consumed.in.MB, MB.sec,
# data.consumed.in.nMsg, nMsg.sec
# 2024-01-15 10:00:00, 2024-01-15 10:00:04, 976.56, 244.14,
# 1000000, 250000.0
# kết luận
Kafka Connect    = Integration không cần code (Source + Sink connectors)
Schema Registry  = Contract management cho events (Avro + compatibility)
EOS              = Idempotent Producer + Transactions (Kafka-to-Kafka only)
Security         = SASL + SSL + ACLs (không optional ở production)
Debezium CDC     = Real-time database change streaming
KRaft            = Kafka không cần ZooKeeper (bắt buộc từ Kafka 4.0)
Strimzi          = Kafka operator cho Kubernetes

Production essentials:
  ✅ Monitoring (Prometheus + Grafana)
  ✅ Alerting (under-replicated, consumer lag, disk)
  ✅ Error handling (DLT + retry + idempotency)
  ✅ Security (authentication + authorization + encryption)
  ✅ Schema management (Schema Registry + compatibility)
  ✅ Graceful shutdown (đặc biệt trên K8s)
  ✅ Incident playbook (đã chuẩn bị sẵn)
Hệ sinh thái Kafka rất rộng. Bài này gom những phần quan trọng nhất mà mình đã dùng ở production. Phần nào cũng đào sâu thêm được, nhưng nắm chừng này thì bạn đã đủ vốn để dựng và vận hành Kafka ở kha khá quy mô. Các API của Spring Kafka, Strimzi, Debezium thay đổi khá nhanh qua từng version, nên trước khi copy config hãy đối chiếu lại docs của đúng version bạn đang dùng.
Part 1 cover basics: Architecture, Producer, Consumer, Patterns. Part 2 (bài này) cover advanced: Connect, Schema Registry, Security, EOS, Testing, K8s, Operations.
Đọc tới đây là respect rồi. Chúc bạn vận hành Kafka production êm. 🎯
Chỉ là những ghi chép cá nhân với hy vọng mang lại chút giá trị. Nếu thấy hữu ích, đừng ngại chia sẻ cho bạn bè & đồng nghiệp nhé!
Happy coding 😎 👍🏻 🚀 🔥.