mongodb
Tung Bui Thanh (TungDaDev)13 mins read
Chọn database bây giờ không chỉ là trả lời câu "lưu cái gì", mà là "lưu thế nào để sau này hệ thống mở rộng cho dễ". MongoDB không phải chỉ là trào lưu NoSQL. Nó rất hợp với kiến trúc theo Domain-Driven Design (DDD), nơi mỗi Aggregate có thể nằm trọn trong một Document.
Bài này là ghi chép từ kinh nghiệm làm thật: kiến trúc bên trong MongoDB, cách thiết kế dữ liệu và index, rồi mấy yêu cầu khắt khe khi đưa lên production.
# core philosophy
MongoDB là một Document Database, lưu dữ liệu dạng BSON (Binary JSON). Không cứng nhắc như RDBMS truyền thống, MongoDB có Schema-flexible model: các document trong cùng một collection có thể có cấu trúc khác nhau, nên phần mềm thay đổi theo thời gian (Software Evolution) cũng đỡ khổ hơn.
Ngoài ra, MongoDB được thiết kế ngay từ đầu cho việc mở rộng ngang (Horizontal Scaling bằng Sharding) và tính sẵn sàng cao (High Availability bằng Replica Sets).
# system architecture
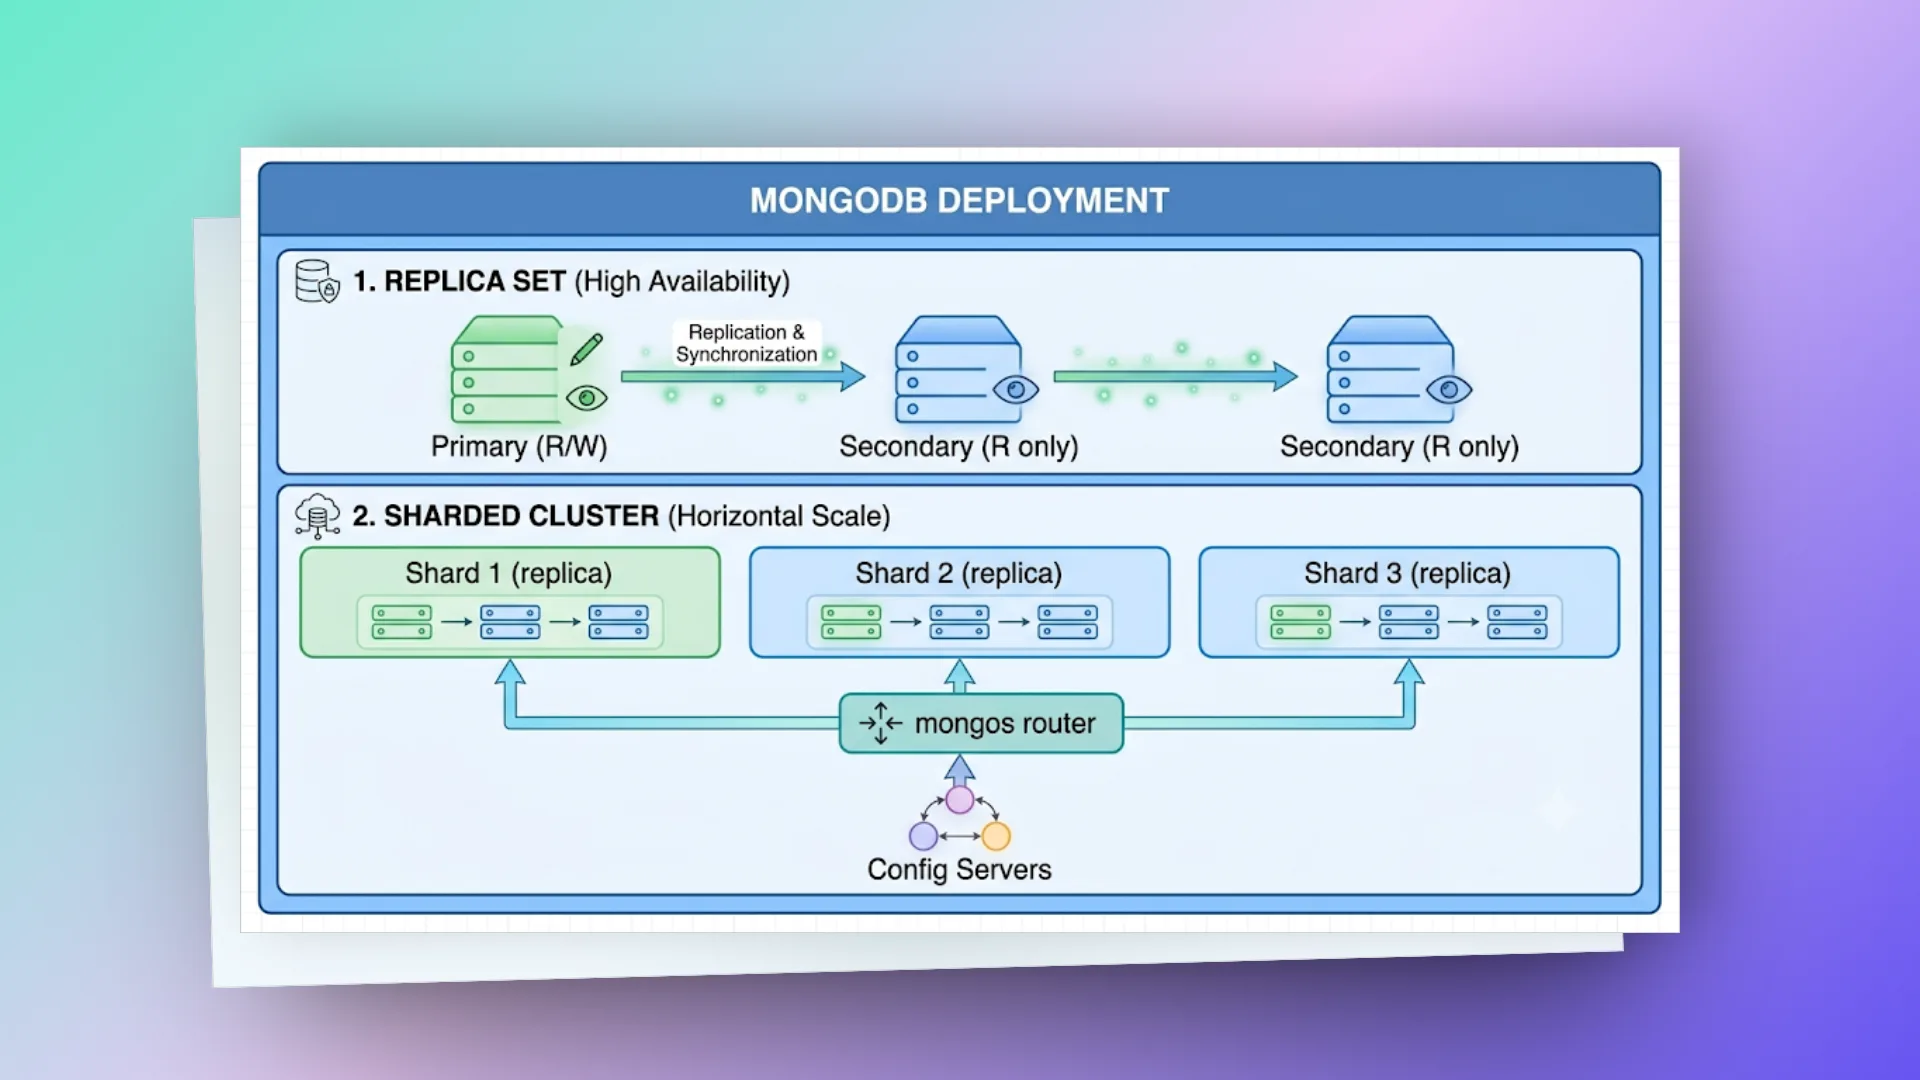
Replica Set: giữ cho dữ liệu không bị mất. Khi node Primary sập, cơ chế bầu chọn (Election) tự chạy và một node Secondary được đẩy lên làm Primary để hệ thống chạy tiếp.
Sharded Cluster: khi dữ liệu phình to quá sức một máy chủ, MongoDB chia dữ liệu ra nhiều Shard dựa trên Shard Key, và client đi qua cổng mongos.
# data model
Trong SQL, chuẩn hoá (Normalization) là kim chỉ nam. Còn trong MongoDB, nguyên tắc là: "dữ liệu được đọc cùng nhau thì nên lưu cùng nhau".
# document structure
{
 "_id": ObjectId("507f1f77bcf86cd799439011"),
 "name": "John Doe",
 "email": "john@example.com",
 "age": 30,
 "address": {
   "street": "123 Main St",
   "city": "Ho Chi Minh",
   "country": "VN"
 },
 "tags": ["developer", "java"],
 "orders": [
   { "orderId": "ORD-001", "total": 500000, "date": ISODate("2024-01-15") }
 ],
 "createdAt": ISODate("2024-01-01T00:00:00Z"),
 "metadata": { "source": "web", "version": 2 }
}
# schema design patterns
Embedded (denormalized): dùng khi quan hệ là 1-to-few và dữ liệu luôn được đọc cùng nhau. Kiểu này rất hợp để mô hình hoá một Aggregate Root trong Clean Architecture.
// User với addresses embedded
{
  "_id": 1,
  "name": "John",
  "addresses": [
    { "type": "home", "city": "HCM" },
    { "type": "work", "city": "HN" }
  ]
}
Referenced (normalized), khi data đọc riêng hoặc grow unbounded: dùng khi quan hệ là 1-to-many (mảng có thể phình mãi, unbounded growth), hoặc khi các entity cần cập nhật độc lập với nhau.
// Order references user
{ "_id": "ORD-001", "userId": ObjectId("..."), "total": 500000 }
Rules of thumb:
- Embed khi: 1-to-few, data luôn đọc cùng, không grow unbounded
- Reference khi: 1-to-many (unbounded), data đọc riêng, cần update độc lập
Lý do phải sợ mảng phình mãi: một document BSON tối đa 16MB, chạm ngưỡng là ghi lỗi luôn. Trước khi chạm ngưỡng thì document to cũng đã làm mỗi lần đọc, ghi, replicate đều phải kéo cả cục qua lại. Ví dụ orders nhét trong user ở phần trên chỉ ổn khi đó là vài đơn gần nhất (bản tóm tắt), còn toàn bộ lịch sử đơn hàng thì nên tách collection riêng.
# crud operations
// Insert
db.users.insertOne({ name: 'John', email: 'john@x.com' })
db.users.insertMany([{ name: 'A' }, { name: 'B' }])

// Find
db.users.find({ age: { $gte: 18, $lte: 65 } })
db.users.find({ tags: { $in: ['java', 'spring'] } })
db.users.find({ 'address.city': 'HCM' }) // nested field
db.users.findOne({ email: 'john@x.com' })

// Update
db.users.updateOne({ _id: ObjectId('...') }, { $set: { name: 'Bob' }, $inc: { loginCount: 1 } })
db.users.updateMany({ status: 'inactive' }, { $set: { archived: true } })

// Delete
db.users.deleteOne({ _id: ObjectId('...') })
db.users.deleteMany({ createdAt: { $lt: ISODate('2023-01-01') } })
# indexes
Backend tệ nhất là cái mà request nào cũng quét nguyên collection (Collection Scan). MongoDB có bộ index khá đầy đủ:
// Single & Unique Index
db.users.createIndex({ email: 1 }, { unique: true })

// Compound Index: Sức mạnh thực sự
db.orders.createIndex({ userId: 1, createdAt: -1 })

// TTL Index: Tự động dọn dẹp dữ liệu (thích hợp cho session, OTP)
db.sessions.createIndex({ createdAt: 1 }, { expireAfterSeconds: 3600 })

// Partial Index: Chỉ index những document thỏa mãn điều kiện, tiết kiệm dung lượng RAM
db.orders.createIndex({ createdAt: 1 }, { partialFilterExpression: { status: 'PENDING' } })

// Wildcard (dynamic fields)
db.products.createIndex({ 'metadata.$**': 1 })
Hai loại cuối hay bị hiểu nhầm. TTL index không xoá đúng giây hết hạn: một background task chạy khoảng 60 giây một lần mới dọn, lúc tải cao còn chậm hơn, nên đừng dựa vào nó để chặn OTP hết hạn mà vẫn phải tự so thời gian khi đọc. Partial index thì chỉ được dùng khi điều kiện query bao trọn partialFilterExpression, ví dụ query có status: 'PENDING'; query không có điều kiện đó thì planner bỏ qua index này.
# index strategies
- Compound index: theo leftmost prefix rule (giống PostgreSQL)
- Covered query: index chứa đủ các field cần → khỏi đọc document
- ESR rule: Equality → Sort → Range (thứ tự field trong compound index)
# aggregation pipeline
Pipeline là chỗ MongoDB mạnh nhất khi cần phân tích và biến đổi dữ liệu. Cứ hình dung nó giống Java Stream API: dữ liệu đi qua từng "stage", được lọc, biến đổi rồi ra kết quả cuối.
db.orders.aggregate([
  // Stage 1: Filter
  {
    $match: { status: 'COMPLETED', createdAt: { $gte: ISODate('2024-01-01') } },
  },

  // Stage 2: Lookup (JOIN)
  {
    $lookup: {
      from: 'users',
      localField: 'userId',
      foreignField: '_id',
      as: 'user',
    },
  },
  { $unwind: '$user' },

  // Stage 3: Group
  {
    $group: {
      _id: '$user.city',
      totalRevenue: { $sum: '$total' },
      orderCount: { $count: {} },
      avgOrderValue: { $avg: '$total' },
    },
  },

  // Stage 4: Sort
  { $sort: { totalRevenue: -1 } },

  // Stage 5: Limit
  { $limit: 10 },

  // Stage 6: Project (reshape output)
  {
    $project: {
      city: '$_id',
      totalRevenue: 1,
      orderCount: 1,
      avgOrderValue: { $round: ['$avgOrderValue', 2] },
    },
  },
])
# common stages
| Stage | Mục đích |
|---|---|
| $match | Lọc document (đặt đầu tiên để dùng index) |
| $group | Gom nhóm (sum, avg, count, min, max) |
| $project | Đổi hình dạng output, thêm/bớt field |
| $sort | Sắp xếp kết quả |
limit / skip | Phân trang |
| $lookup | JOIN với collection khác |
| $unwind | Trải phẳng mảng |
| $addFields | Thêm field tính toán |
| $facet | Chạy nhiều sub-pipeline trên cùng input |
# replica set
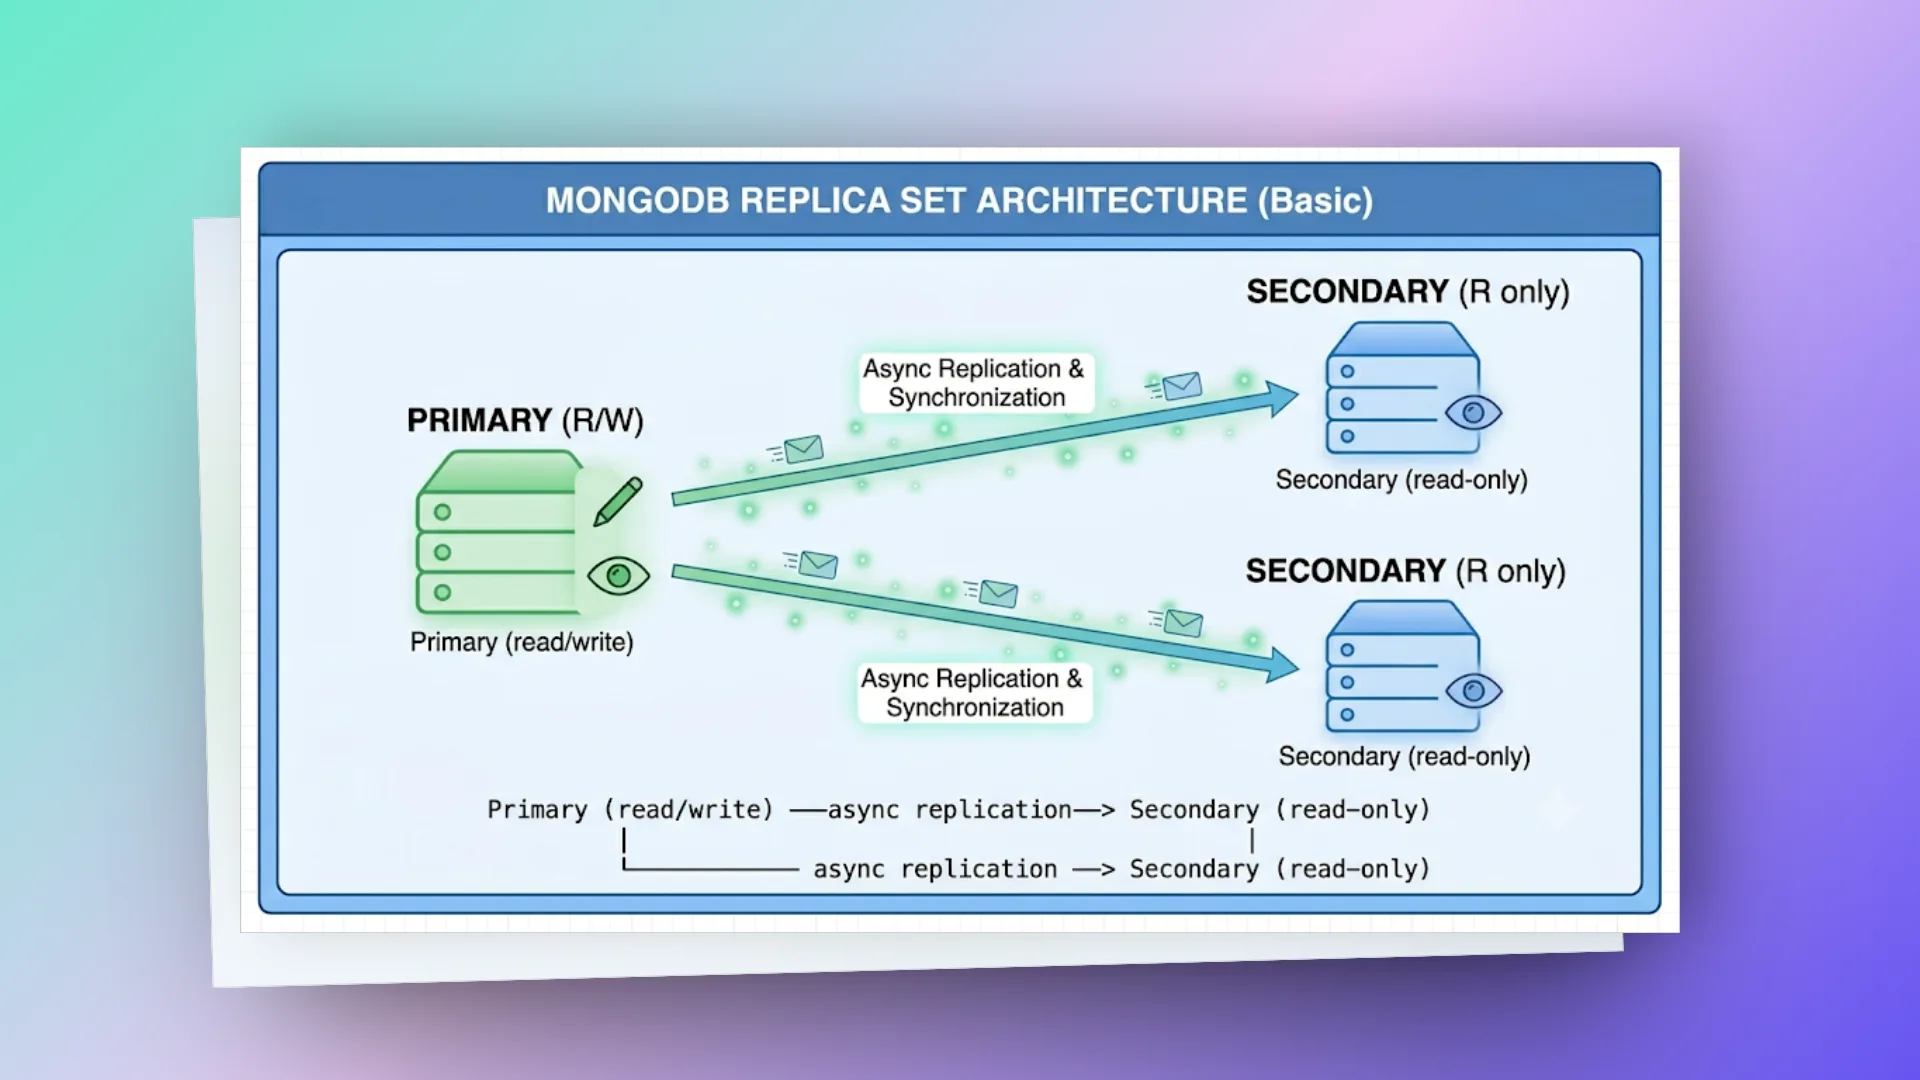
Election: Primary chết → các Secondary bỏ phiếu → bầu ra Primary mới
Tối thiểu: 3 members (hoặc 2 + 1 arbiter)
Mặc định một node không liên lạc được với Primary khoảng 10 giây (electionTimeoutMillis) thì mới gọi bầu, nên lúc failover app sẽ thấy lỗi ghi vài giây; driver có retryable writes để tự thử lại. Kiểu 2 + 1 arbiter rẻ nhưng MongoDB khuyên tránh: arbiter không giữ dữ liệu, một node data chết là write concern majority không đạt được nữa.
# read preference
// Spring Data MongoDB 4.2+
@ReadPreference("secondaryPreferred")
List<User> findByCity(String city);| Preference | Đọc từ | Use case |
|---|---|---|
| primary | Chỉ Primary | Mặc định, strong consistency |
| primaryPreferred | Primary, lỗi thì sang secondary | Gần như luôn nhất quán |
| secondary | Chỉ Secondary | Analytics, báo cáo |
| secondaryPreferred | Secondary, lỗi thì về primary | Scale việc đọc, chấp nhận trễ |
| nearest | Node có latency thấp nhất | Hệ thống trải nhiều vùng địa lý |
# write concern
// Đảm bảo write replicated trước khi confirm
mongoTemplate.setWriteConcern(WriteConcern.MAJORITY); // wait for majority ack
Từ MongoDB 5.0, write concern mặc định đã là majority (trừ vài cấu hình có arbiter), nên dòng trên chủ yếu để ghi rõ ý đồ, hoặc để cấu hình kiểu cũ. Đọc từ secondary thì nhớ dữ liệu có thể trễ hơn primary một chút (replication lag), vừa ghi xong đọc lại từ secondary có khi chưa thấy.
# sharding
Chia dữ liệu ra nhiều server:
Shard Key: { userId: "hashed" }
 hash(userId) chia thanh cac khoang (chunk):
   [min, -3e18)   -> Shard 1
   [-3e18, 3e18)  -> Shard 2
   [3e18, max]    -> Shard 3
MongoDB không chia kiểu hash % số shard. Giá trị hash được cắt thành các khoảng (chunk), balancer chuyển chunk giữa các shard cho đều. Nhờ vậy thêm shard mới chỉ cần dời một phần chunk sang, không phải tính lại toàn bộ như phép modulo.
# chọn shard key (rất quan trọng, chọn rồi khó đổi!)
Từ MongoDB 5.0 đã có reshardCollection để đổi shard key, nhưng nó chép lại toàn bộ dữ liệu của collection, tốn nhiều thời gian và tài nguyên. Nên vẫn phải chọn kỹ từ đầu:
- High cardinality (nhiều giá trị khác nhau)
- Phân bố đều
- Query isolation (query chỉ trúng 1 shard, không phải rải đi mọi shard)
- Ghi phân tán đều (tránh hot shard)
Tốt: { userId: "hashed" }, { tenantId: 1, createdAt: 1 } Tệ: { status: 1 } (low cardinality), { createdAt: 1 } (tăng dần đều → hot shard)
# spring data mongodb
Spring Boot đi với MongoDB là cặp rất hợp cho microservices. Một lưu ý trước khi xem code: từ Spring Data MongoDB 3.0, annotation index (@Indexed, @CompoundIndex) không tự tạo index nữa, trừ khi bật spring.data.mongodb.auto-index-creation=true. Production thì nên tạo index bằng migration (Mongock, script) để kiểm soát thời điểm build index.
# entity
@Document(collection = "process_definitions")
// Mỗi key có nhiều version, nên unique phải là bộ (workspaceId, key, version)
@CompoundIndex(name = "uk_workspace_key_version",
               def = "{'workspaceId': 1, 'key': 1, 'version': 1}", unique = true)
@Data
@Builder
@NoArgsConstructor
@AllArgsConstructor
public class ProcessDefinition {

   @Id
   private String id;

   private String key;

   private String name;
   private String workspaceId;
   private int version;

   @Field("created_at")
   private Instant createdAt;

   private Map<String, Object> metadata;
   private List<String> tags;
}
# repository
public interface ProcessDefinitionRepository extends MongoRepository<ProcessDefinition, String> {

   List<ProcessDefinition> findByWorkspaceIdAndVersion(String workspaceId, int version);

   @Query("{ 'workspaceId': ?0, 'tags': { $in: ?1 } }")
   List<ProcessDefinition> findByWorkspaceAndTags(String workspaceId, List<String> tags);

   @Aggregation(pipeline = {
       "{ $match: { workspaceId: ?0 } }",
       "{ $group: { _id: '$key', latestVersion: { $max: '$version' } } }"
   })
   List<Document> findLatestVersions(String workspaceId);
}
# mongotemplate (complex queries)
MongoRepository lo tốt mấy việc CRUD cơ bản, còn logic nghiệp vụ phức tạp thì MongoTemplate cho bạn tuỳ biến thoải mái hơn.
@Service
@RequiredArgsConstructor
public class ProcessDefinitionService {

   private final MongoTemplate mongoTemplate;

   public List<ProcessDefinition> search(String workspace, String keyword, Pageable pageable) {
       // Escape input của user, không thì "(a+)+$" cũng thành regex chạy được (ReDoS)
       String safeKeyword = Pattern.quote(keyword);

       Criteria criteria = new Criteria().andOperator(
           Criteria.where("workspaceId").is(workspace),
           new Criteria().orOperator(
               Criteria.where("name").regex(safeKeyword, "i"),
               Criteria.where("key").regex(safeKeyword, "i")
           )
       );

       Query query = new Query(criteria)
           .with(pageable)
           .with(Sort.by(Sort.Direction.DESC, "createdAt")); // tên property Java, Spring tự map sang created_at

       return mongoTemplate.find(query, ProcessDefinition.class);
   }
}
# change streams (real-time)
Change Streams rất đáng giá khi bạn làm kiến trúc Event-Driven hoặc CQRS (dùng MongoDB làm read model phía query). Nó cho app "nghe" được các thay đổi dữ liệu theo thời gian thực ngay ở tầng database. Bên dưới, change stream đọc từ oplog, nên chỉ chạy trên replica set hoặc sharded cluster, MongoDB standalone thì không có.
Một lỗi dễ mắc là gọi watch().forEach() ngay trong @PostConstruct. Vòng lặp đó không bao giờ kết thúc, nên app treo luôn ở bước khởi tạo bean. Code dưới đẩy nó sang thread riêng.
@Component
@Slf4j
@RequiredArgsConstructor
public class OrderChangeStreamListener {

   private final MongoTemplate mongoTemplate;
   private final KafkaTemplate<String, Object> kafkaTemplate;
   private final ExecutorService executor = Executors.newSingleThreadExecutor();

   @EventListener(ApplicationReadyEvent.class)
   public void start() {
       // watch().forEach() chặn thread mãi mãi, nên phải chạy trên thread riêng
       executor.submit(this::watchOrderChanges);
   }

   private void watchOrderChanges() {
       mongoTemplate.getCollection("orders")
           .watch(List.of(
               Aggregates.match(Filters.in("operationType", "insert", "update"))
           ))
           .fullDocument(FullDocument.UPDATE_LOOKUP) // thiếu dòng này thì event update có fullDocument = null
           .forEach(event -> {
               log.info("Document thay đổi: {} | Thao tác: {}",
                   event.getDocumentKey(), event.getOperationType());

               // Bắn event ra Kafka để các service khác xử lý (kiểu CDC)
               kafkaTemplate.send("order-events", event.getFullDocument());
               // Production: lưu event.getResumeToken() để restart xong chạy tiếp đúng chỗ
           });
   }

   @PreDestroy
   public void stop() {
       executor.shutdownNow();
   }
}
Cách này là CDC (change data capture), chưa phải Outbox pattern đúng nghĩa: Outbox ghi event vào một collection riêng trong cùng transaction với dữ liệu nghiệp vụ, rồi mới có tiến trình đẩy ra Kafka. Dù chọn cách nào thì cũng chỉ đạt at-least-once: app chết sau khi gửi Kafka mà chưa kịp lưu resume token thì lần sau event bị gửi lại, nên consumer phía sau phải xử lý trùng được. Resume token cũng chỉ dùng được khi thời điểm đó còn nằm trong oplog, app dừng quá lâu thì phải đồng bộ lại từ đầu. Chạy nhiều instance của service thì mỗi instance đều nhận đủ mọi event, cần cơ chế chọn một instance (leader lock) nếu không muốn gửi trùng.
# performance tips
- Đặt
$matchở đầu pipeline (để dùng index) - Dùng projection (chỉ lấy field cần)
- Cẩn thận với
$lookuptrên collection lớn: mỗi document bên trái phải tìm bên phải,foreignFieldkhông có index là quét lại cả collection - Đánh index cho các field dùng để sort
- Compound index theo ESR rule
- Theo dõi bằng
db.currentOp(),db.collection.explain() - Đặt
maxTimeMScho query
# production checklist
Muốn hệ thống chạy ổn trên production thì đừng bỏ qua mấy mục này:
- Kiến trúc: bắt buộc chạy Replica set (tối thiểu 3 node).
- An toàn dữ liệu (Write Concern): đặt MAJORITY để chắc dữ liệu đã được ghi trên đa số node.
- Điều hướng đọc (Read Preference): đặt secondaryPreferred cho mấy tác vụ xuất report nặng để Primary đỡ tải.
- Hiệu năng: theo quy tắc ESR cho Compound Index. Không dùng $lookup trên collection cả triệu bản ghi nếu không có index đỡ.
- Bảo mật & vận hành: bật Schema Validation ở tầng database để chặn dữ liệu rác. Theo dõi sát Oplog lag và slow query qua db.currentOp().
- Mở rộng: tính kỹ Shard Key ngay từ ngày đầu, vì đổi Shard Key về sau (
reshardCollection) rất tốn kém.
Chỉ là những ghi chép cá nhân với hy vọng mang lại chút giá trị. Nếu thấy hữu ích, đừng ngại chia sẻ cho bạn bè & đồng nghiệp nhé!
Happy coding 😎 👍🏻 🚀 🔥.