Welcome to MikeDaDev's Blog – notes on Java, backend & system design.

Explore
MikeDaDev's Blog

All posts

I like to write about stuff I'm into. You'll find a mix of web dev articles, tech news and random thoughts from my life. Use the search below to filter by title.

transactional outbox & idempotent consumer

Xử lý bài toán Dual-Write cho đúng: Transactional Outbox với Debezium SMT, kỹ thuật SELECT FOR UPDATE SKIP LOCKED, vì sao Kafka transaction không cứu được bạn ở đây, và cách làm Idempotent Consumer chạy được trên production với RDBMS (kèm Redis làm lớp lọc nhanh).
in ai / slm

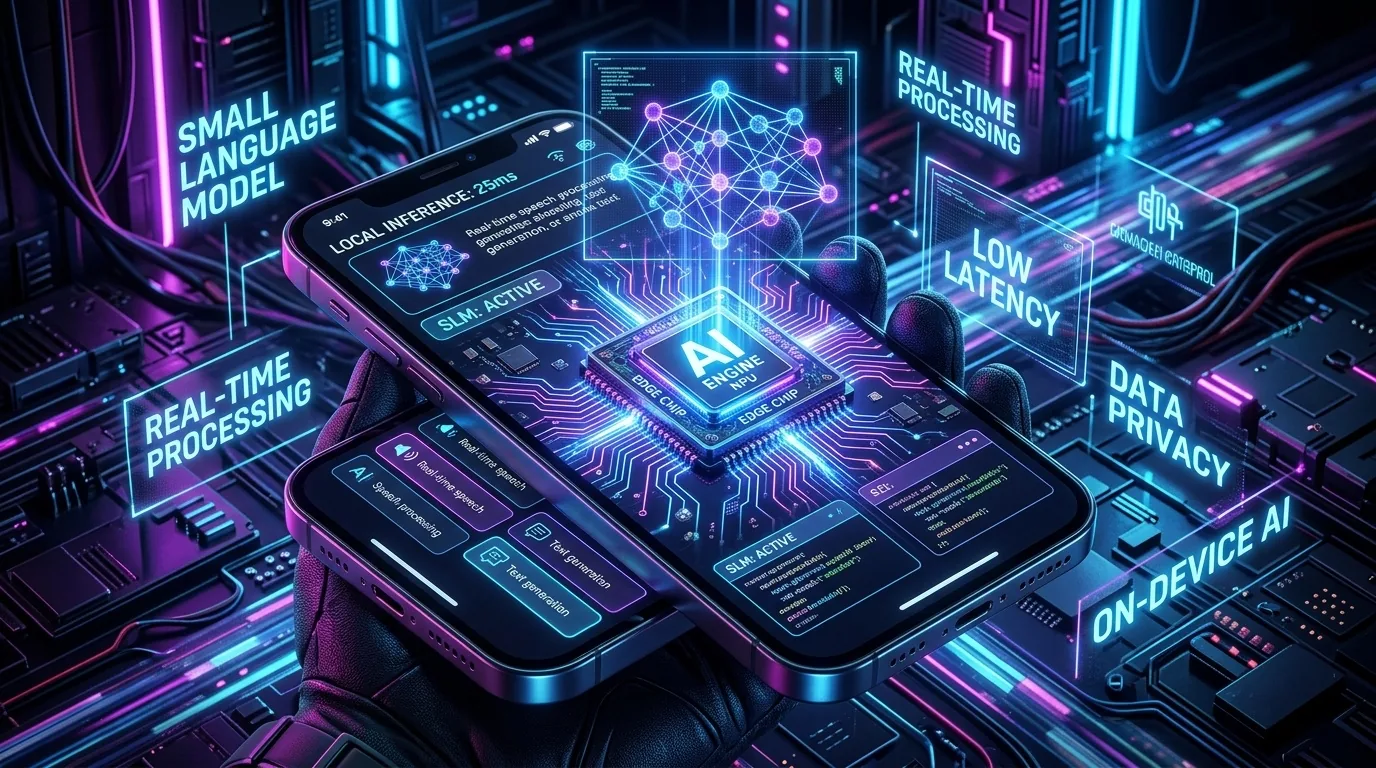
Small Language Models (SLM)

Nhìn Small Language Models (1B - 8B) từ góc độ người làm kiến trúc: tính VRAM và KV-Cache, chọn kiểu lượng tử hoá (AWQ hay GGUF), chạy Dynamic Multi-LoRA trên vLLM, ghép SLM với LLM thành Compound AI, và bài toán TCO, ROI.

in ai / llm

reasoning models & test-time compute

DeepSeek-R1 làm cả ngành AI giật mình vì cho thấy năng lực của model không chỉ tăng nhờ pre-training mà còn nhờ cho model nghĩ lâu hơn lúc suy luận (test-time compute). Bài này nói về chuyện đó: scaling law, cách DeepSeek dùng Reinforcement Learning với GRPO, kiến trúc MoE/MLA, và dev phần mềm rút ra được gì.

LMAX Disruptor & kiến trúc lock-free

Sàn giao dịch tài chính LMAX xử lý khoảng 6 triệu lệnh mỗi giây trên một luồng CPU duy nhất, truyền message giữa các thread chỉ mất vài chục nano giây, và viết bằng Java. Bài này đi qua cấu trúc RingBuffer, hiện tượng False Sharing, Cache Line Padding và cách làm lock-free của Disruptor.

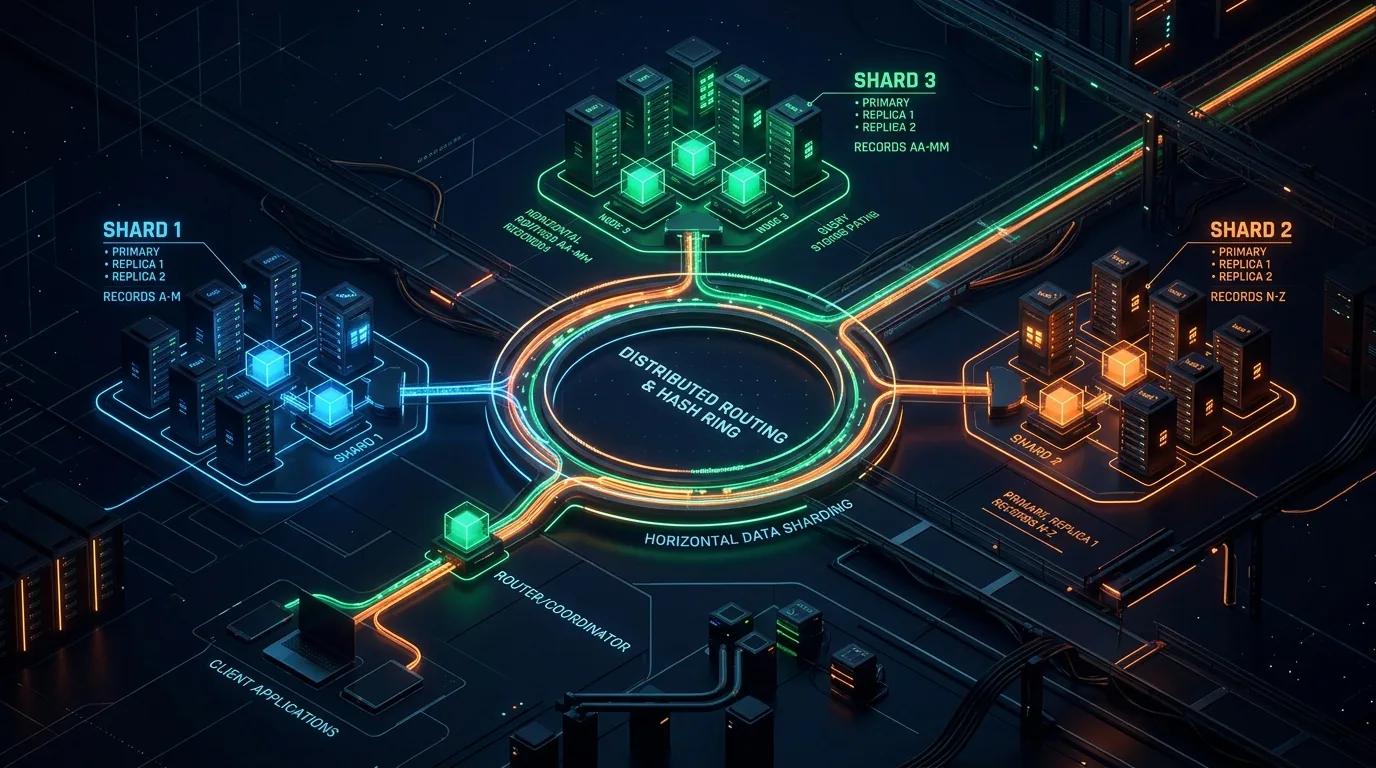
Database Sharding system design

Lúc nào thì một node SQL không còn gánh nổi tải? Bài này nói về cách ước tính dung lượng nhanh (back-of-the-envelope), cách chọn sharding key, chuyện transaction phân tán và kinh nghiệm từ các hệ thống tài chính.

in ai / agent

langgraph & stateful multi-agent

Vì sao Chain tuyến tính (DAG) không đủ cho AI Agent phức tạp? Bài này nói về kiến trúc LangGraph, tư duy State Machine, cơ chế time-travel và mấy mẫu phối hợp multi-agent hay gặp.

zero-downtime database migration

Làm Zero-Downtime Migration cho database: ma trận lock như AccessExclusiveLock, chiến lược Expand-Contract 5 pha, Shadow Reads (dark launching), Throttled Keyset Backfill và so sánh gh-ost với pg_repack.

in ai / llm

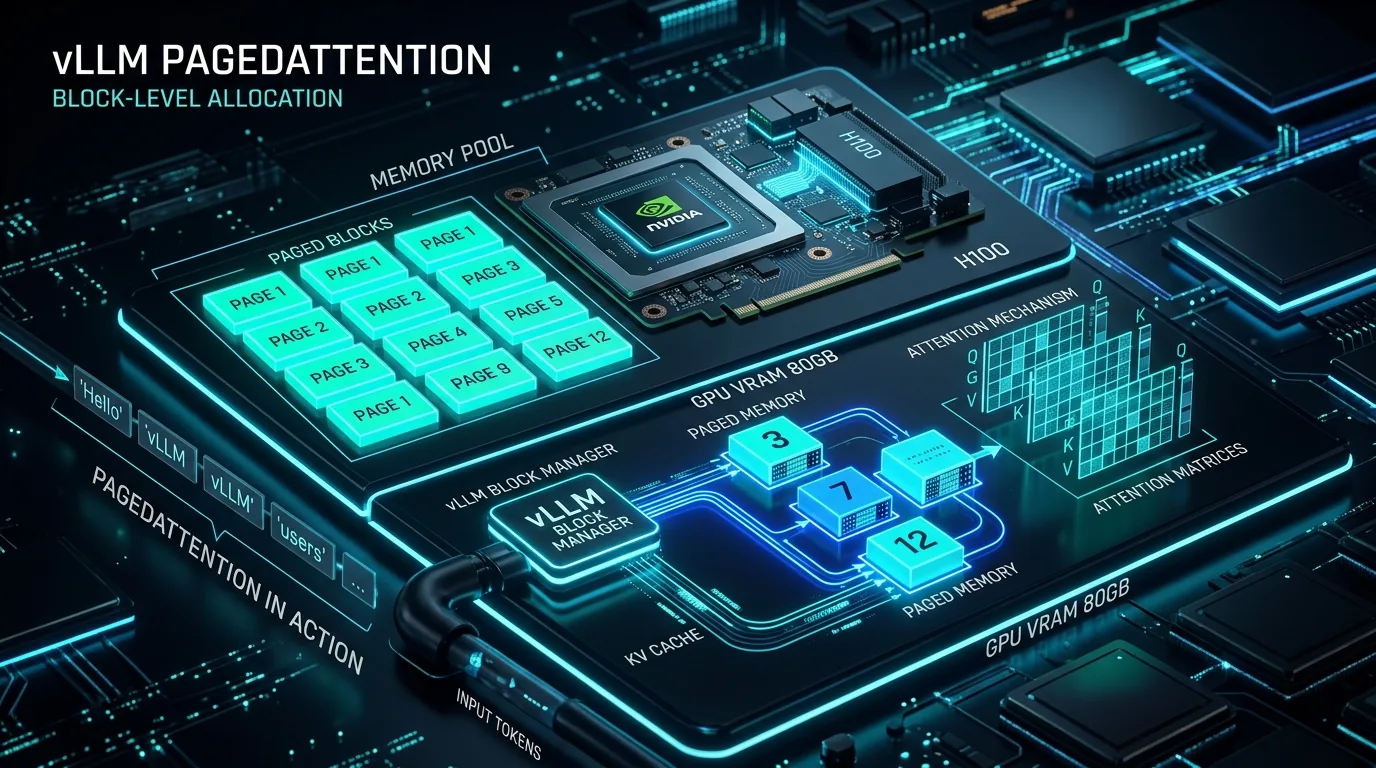
vLLM & PagedAttention

Model chỉ nặng vài chục GB mà GPU cứ báo hết VRAM? Thủ phạm là KV Cache. Bài này mổ xẻ chuyện KV Cache phình to, cách PagedAttention mượn ý tưởng bộ nhớ ảo của hệ điều hành để xử lý nó, và vì sao vLLM đẩy throughput suy luận lên cao gấp nhiều lần (tới 24 lần so với HuggingFace Transformers, theo số đo của nhóm tác giả).