postgre-sql
Tung Bui Thanh (TungDaDev)13 mins read
Làm backend tải cao thì chọn được database tốt mới là bước đầu, hiểu nó chạy bên dưới ra sao mới là chuyện quyết định hệ thống có vững hay không. Nhất là khi bạn theo Clean Architecture hay CQRS, PostgreSQL hay được giao làm "trái tim" cho Command-side (Write model), lúc đó không hiểu nó "thở" thế nào là không được.
Bài này không ngồi liệt kê cú pháp. Mình sẽ nói về cách nó lưu dữ liệu, cách xử lý đồng thời, và mấy mẹo tối ưu mà dev backend nên biết.
# bản chất
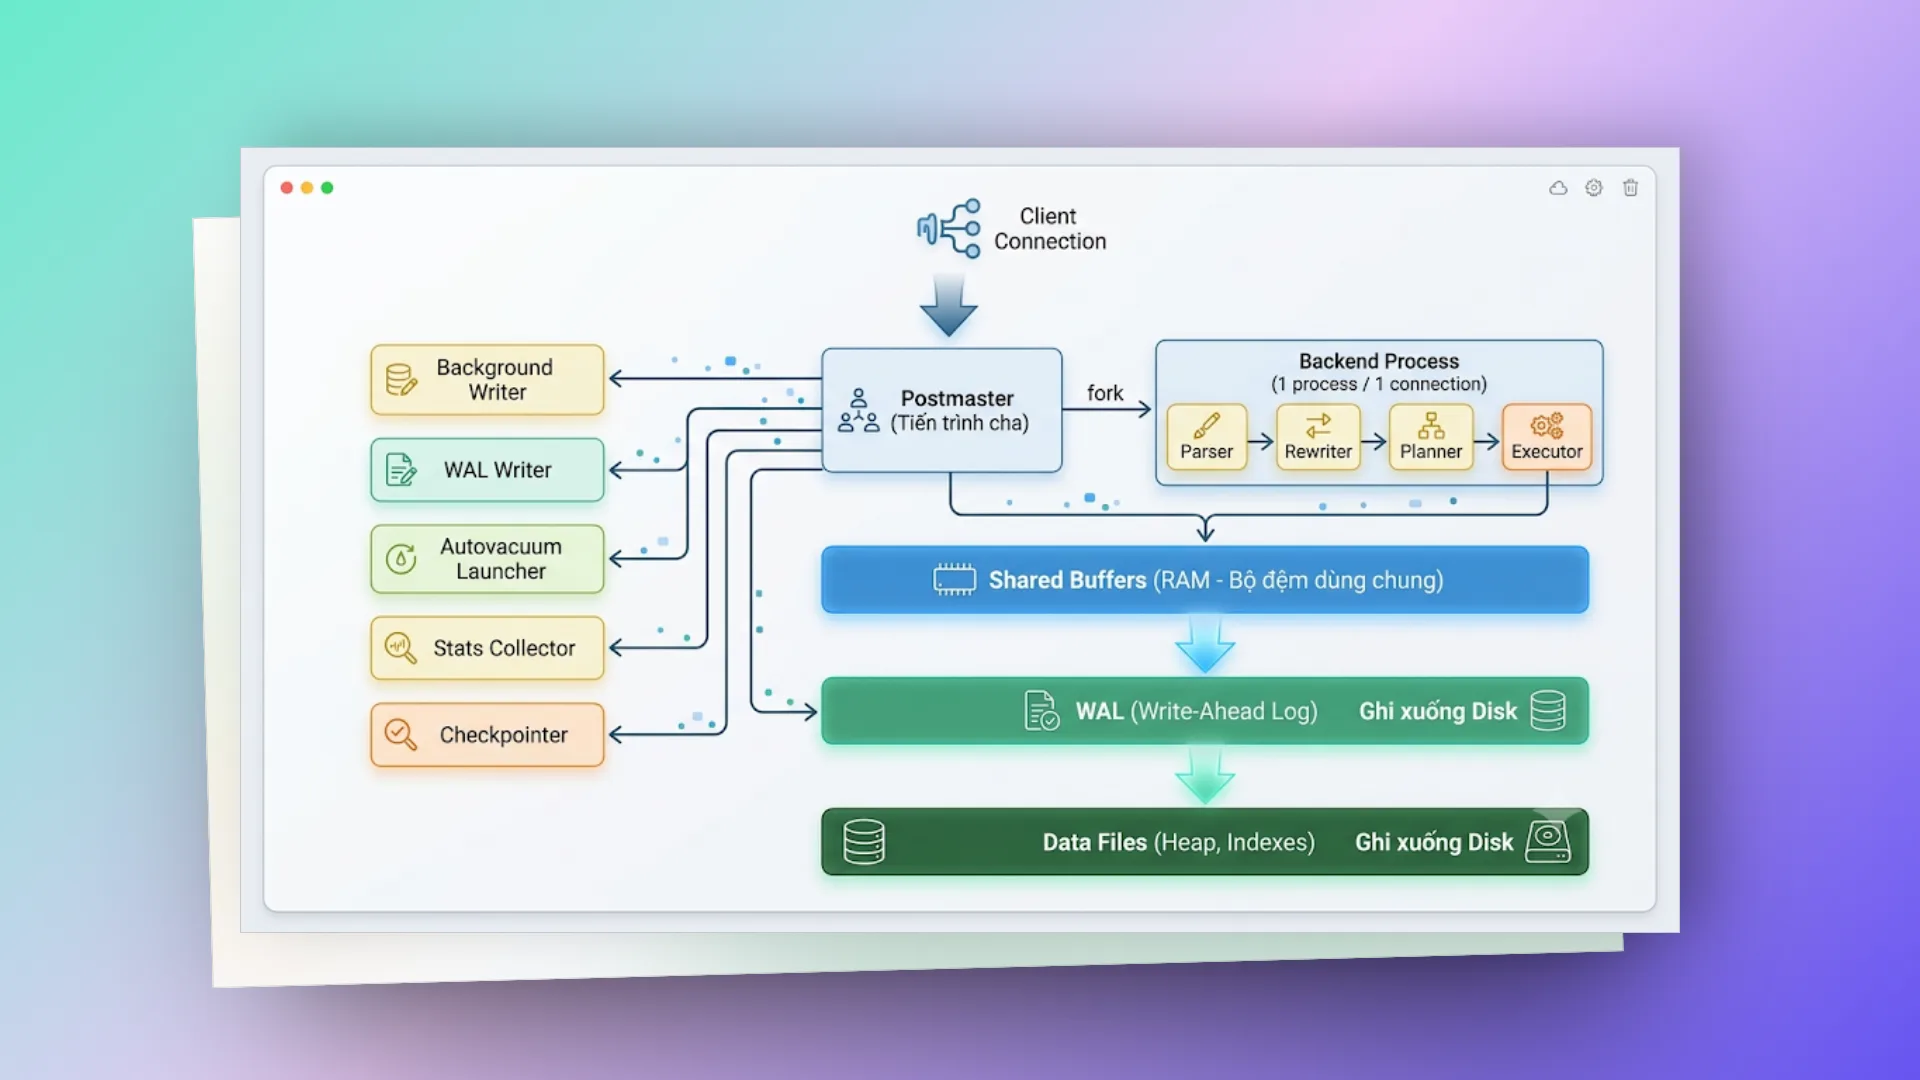
PostgreSQL là một Object-Relational Database, tuân thủ ACID rất chặt. MySQL dùng mô hình thread-per-connection (mỗi kết nối một thread), còn PostgreSQL thì vẫn giữ kiểu Process-per-connection.
Tức là mỗi client kết nối vào, hệ điều hành fork ra một process riêng. Bộ nhớ giữa các kết nối tách bạch hẳn, đổi lại là khởi tạo tốn hơn và ăn RAM nhiều hơn.
# mvcc (multi-version concurrency control)
Nhiều bạn bất ngờ khi biết PostgreSQL không lock row lúc đọc. Bí mật nằm ở MVCC, tức là quản lý đồng thời bằng nhiều phiên bản.
Thay vì ghi đè lên dữ liệu cũ, mỗi thao tác tạo ra một phiên bản mới của dòng (row version):
UPDATE users SET name = 'Bob' WHERE id = 1;Trước khi update: Row(id=1, name='Alice', xmin=100, xmax=0). xmin là ID của transaction tạo ra phiên bản này, xmax = 0 nghĩa là chưa ai xoá/sửa nó.
Sau khi transaction 200 update:
- Row(id=1, name='Alice', xmin=100, xmax=200): phiên bản cũ. Transaction nào có snapshot chụp trước khi 200 commit vẫn thấy nó; sau khi không còn ai cần nữa thì nó thành dead tuple.
- Row(id=1, name='Bob', xmin=200, xmax=0): phiên bản mới, chỉ những snapshot chụp sau khi 200 commit mới thấy.
Một transaction "thấy" phiên bản nào là do snapshot của nó quyết định (transaction nào đã commit tại thời điểm chụp), chứ không đơn giản là so ID lớn hơn hay nhỏ hơn.
Điều cần nhớ: trong PostgreSQL, SELECT thường không block writer, writer cũng không block SELECT thường. Ngoại lệ là SELECT ... FOR UPDATE/FOR SHARE (chủ động khoá row) và các lệnh cần khoá cả bảng như ALTER TABLE, VACUUM FULL. Hai writer cùng sửa một row thì vẫn phải chờ nhau. UPDATE thật ra là INSERT một phiên bản mới, rồi đánh dấu xoá phiên bản cũ (nếu không cột nào có index bị đổi và page còn chỗ, PostgreSQL dùng HOT update để khỏi phải cập nhật index).
Cái giá phải trả là rác: dead tuple tích dần, làm database phình ra (bloat). Lúc đó cần tới anh lao công: VACUUM.
# vacuum
VACUUM quét qua các data page, thu hồi chỗ mà dead tuple đang chiếm để bản ghi mới sau này dùng lại.
-- Dọn rác cơ bản
VACUUM VERBOSE users;

-- Dọn rác và dồn mảnh (Trả lại dung lượng đĩa thực tế nhưng sẽ LOCK TABLE toàn bộ!)
VACUUM FULL users;

-- Cập nhật lại thống kê dữ liệu cho Query Planner
VACUUM ANALYZE users;
Trên production thì ít ai gọi tay, mình để Autovacuum lo:
-- Cấu hình tinh chỉnh ngưỡng kích hoạt Autovacuum
ALTER TABLE users SET (
   autovacuum_vacuum_threshold = 50,           -- Số dead tuples tối thiểu để kích hoạt
   autovacuum_vacuum_scale_factor = 0.1,       -- Kích hoạt khi 10% table biến thành rác
   autovacuum_analyze_threshold = 50,
   autovacuum_analyze_scale_factor = 0.05
);
Khi nào autovacuum chạy: dead_tuples > threshold + scale_factor * table_size
Table bloat: vacuum dọn không kịp thì table phình to (dead tuple chiếm chỗ). Cách sửa: VACUUM FULL (nhưng lock table) hoặc pg_repack (chạy online). Bảng nào write/update dày đặc thì hạ scale_factor xuống cho Autovacuum chạy thường hơn, đừng để bloat nặng tới mức phải lôi pg_repack ra.
# wal (write-ahead log)
Thay đổi dữ liệu không ghi thẳng vào data file (heap) mà phải đi qua một chốt an toàn tên là WAL trước.
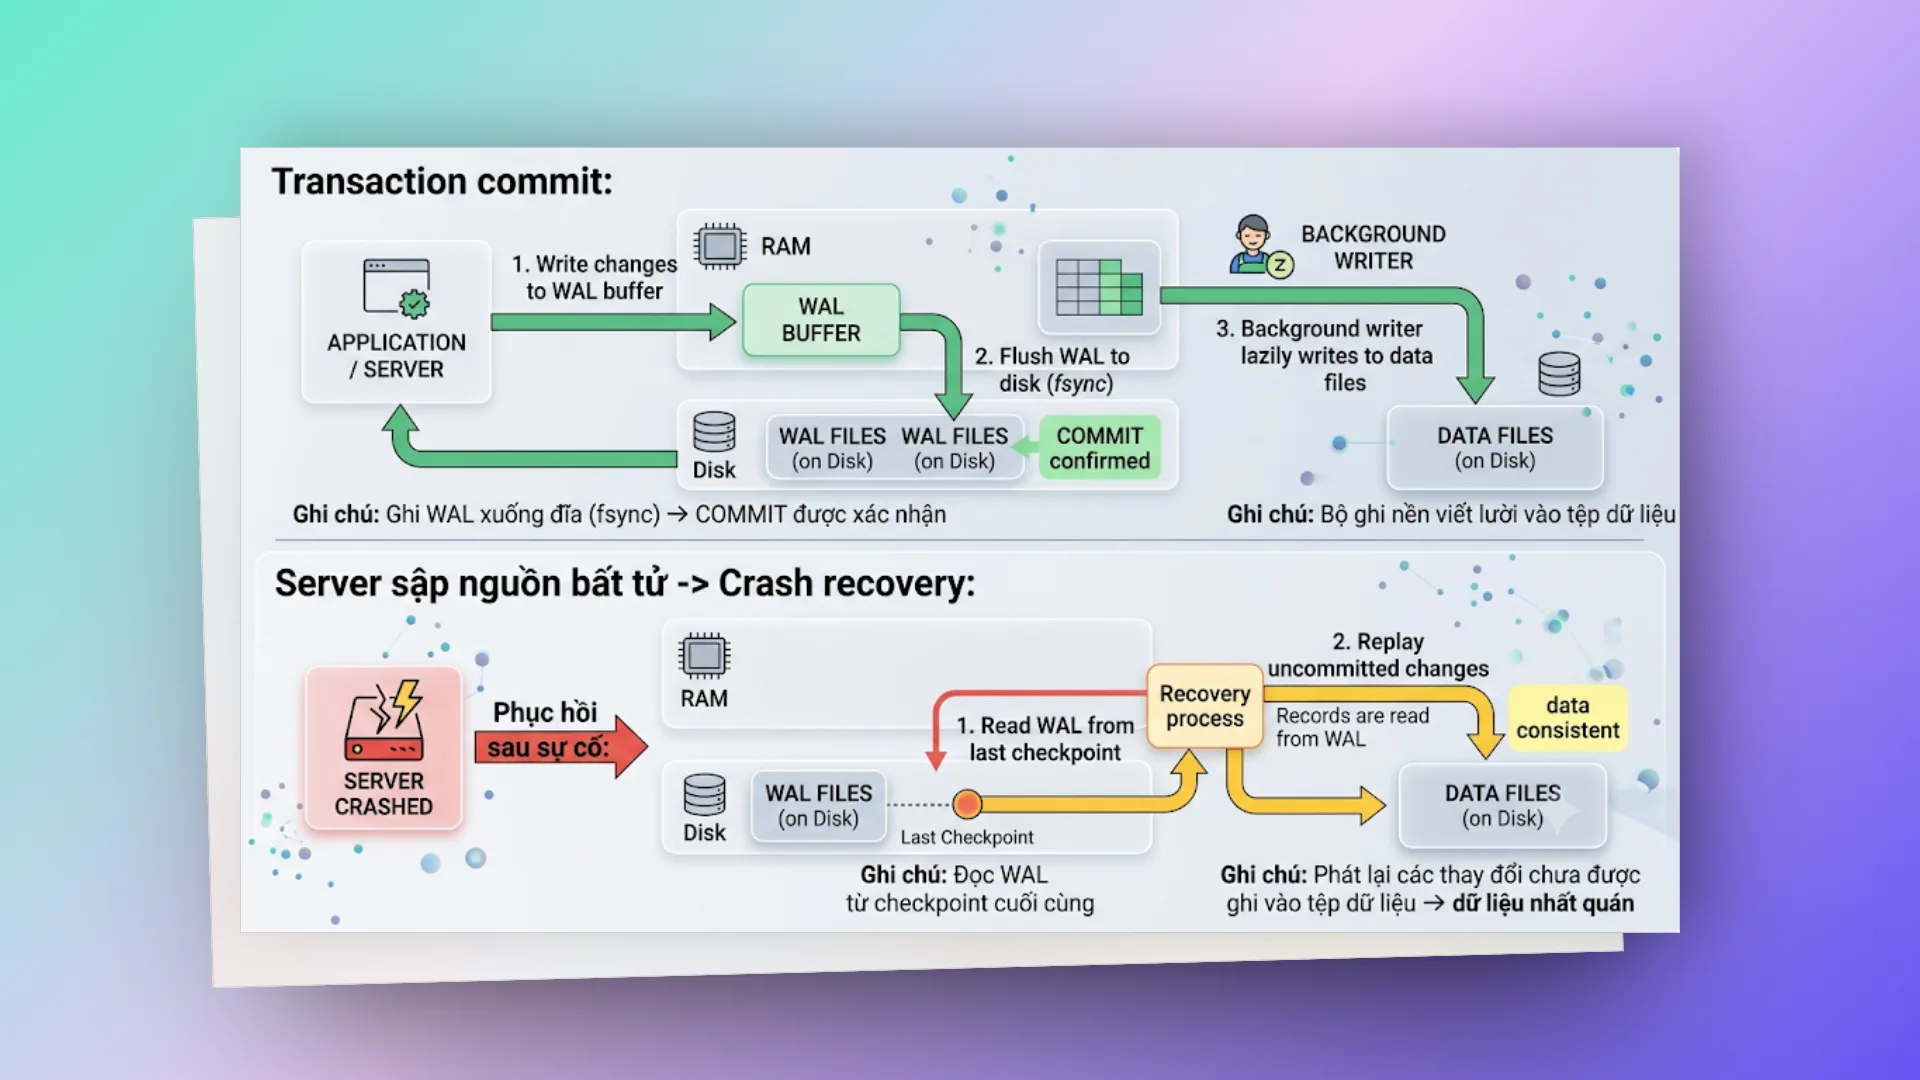
WAL lo phần durability (chữ D trong ACID). Lúc COMMIT, PostgreSQL chỉ cần ghi (fsync) bản ghi WAL xuống đĩa là xong; các data page bị sửa nằm trong shared buffers và được ghi ra data file sau, ở các lần checkpoint. Ghi tuần tự vào cuối file WAL rẻ hơn nhiều so với ghi ngẫu nhiên vào từng page. Crash giữa chừng thì replay WAL từ checkpoint gần nhất là khôi phục lại được. Cũng chính WAL này được dùng cho streaming replication và logical decoding (CDC).
# indexes
Index là con dao hai lưỡi. Hiểu từng loại index được xây bằng cấu trúc gì thì mới dùng đúng chỗ:
# b-tree (default, phổ biến nhất)
CREATE INDEX idx_users_email ON users(email);
-- Tốt cho: =, <, >, <=, >=, BETWEEN, IN, LIKE 'prefix%'
-- (LIKE 'prefix%' chỉ dùng được index nếu DB collation là "C",
--  còn không phải tạo index với operator class: users(email text_pattern_ops))
-- Không tốt cho: LIKE '%suffix', full-text search
# hash
CREATE INDEX idx_users_email_hash ON users USING hash(email);
-- Chỉ tốt cho: = (equality)
-- Có thể nhỏ hơn B-Tree khi key dài; thực tế B-Tree thường đủ tốt
-- Chỉ an toàn khi crash (WAL-logged) từ PostgreSQL 10
# gin (generalized inverted index)
CREATE INDEX idx_users_tags ON users USING gin(tags);
-- Tốt cho: arrays, JSONB, full-text search
-- @>, ?, ?|, ?&, @@
# gist (generalized search tree)
CREATE INDEX idx_locations_point ON locations USING gist(coordinates);
-- Tốt cho: geometric, range types, full-text search -> dữ liệu không gian, hình học
-- <<, >>, &&, @>
# partial index
Chỉ index phần dữ liệu thật sự cần, đỡ được rất nhiều RAM và dung lượng.
-- Chỉ index rows thỏa condition → nhỏ hơn, nhanh hơn
CREATE INDEX idx_orders_pending ON orders(created_at)
   WHERE status = 'PENDING';
# composite index
CREATE INDEX idx_orders_user_status ON orders(user_id, status);
-- Tốt cho: WHERE user_id = ? AND status = ?
-- Cũng tốt cho: WHERE user_id = ? (leftmost prefix)
-- KHÔNG tốt cho: WHERE status = ? (cột đầu không có trong điều kiện;
--   PG 18 có skip scan nhưng chỉ lợi khi cột đầu ít giá trị, user_id thì không)
# covering index (include)
Covering Index (INCLUDE): cho phép Index-Only Scan, lấy dữ liệu thẳng từ cây index mà không cần đụng tới heap table.
CREATE INDEX idx_orders_user ON orders(user_id) INCLUDE (status, total);
-- Index-only scan: không cần đọc heap table
INCLUDE có từ PostgreSQL 11. Một chi tiết hay bị bỏ qua: index trong PostgreSQL không lưu thông tin MVCC, nên Index-Only Scan chỉ bỏ qua được heap với những page đã được đánh dấu "all-visible" trong visibility map (việc của VACUUM). Bảng update liên tục mà vacuum chạy không kịp thì EXPLAIN ANALYZE sẽ hiện Heap Fetches lớn, index-only scan lúc đó chẳng khác index scan là mấy.
# query optimization
# explain analyze
EXPLAIN (ANALYZE, BUFFERS, FORMAT TEXT)
SELECT * FROM orders WHERE user_id = 'abc' AND status = 'PENDING';

-- Output:
-- Index Scan using idx_orders_user_status on orders (cost=0.43..8.45 rows=1 width=200)
--   (actual time=0.023..0.025 rows=1 loops=1)
--   Index Cond: (user_id = 'abc' AND status = 'PENDING')
--   Buffers: shared hit=4
-- Planning Time: 0.150 ms
-- Execution Time: 0.050 ms
# scan types (tốt → xấu)
| Scan | Ý nghĩa | Performance |
|---|---|---|
| Index Only Scan | Đọc từ index, không cần heap | Tốt nhất |
| Index Scan | Dùng index, đọc heap cho data | Tốt |
| Bitmap Index Scan | Dùng index tạo bitmap, đọc heap | OK cho nhiều rows |
| Seq Scan | Full table scan | Tệ cho large tables |
Thứ tự trên chỉ đúng khi query lấy ít dòng. Query cần đọc phần lớn bảng thì Seq Scan lại là lựa chọn rẻ nhất, vì đọc tuần tự nhanh hơn nhảy qua index rồi đọc heap ngẫu nhiên. Thấy Seq Scan đừng vội thêm index, xem số dòng trả về trước.
# common optimization patterns
-- 1. Avoid SELECT *
SELECT id, name, email FROM users WHERE ...;

-- 2. EXISTS vs IN: PostgreSQL thường biến cả hai thành semi-join, plan như nhau.
--    Chỗ cần tránh là NOT IN (subquery): subquery có NULL là ra rỗng, và khó tối ưu → dùng NOT EXISTS
SELECT * FROM orders o WHERE EXISTS (
   SELECT 1 FROM users u WHERE u.id = o.user_id AND u.active = true
);

-- 3. Pagination with keyset (không dùng OFFSET cho large datasets)
SELECT * FROM orders WHERE id > :last_id ORDER BY id LIMIT 20;
-- Thay vì: SELECT * FROM orders ORDER BY id LIMIT 20 OFFSET 10000; (slow!)

-- 4. Batch operations
INSERT INTO orders (id, user_id, total) VALUES
   ('1', 'u1', 100), ('2', 'u2', 200), ('3', 'u3', 300);

-- 5. Use COPY for bulk load
-- (đọc file trên MÁY CHỦ database, cần superuser hoặc role pg_read_server_files;
--  file nằm ở máy client thì dùng \copy của psql, hoặc CopyManager của JDBC driver)
COPY orders FROM '/tmp/orders.csv' WITH (FORMAT csv, HEADER true);
# transactions & isolation levels
| Level | Dirty Read | Non-Repeatable Read | Phantom Read | Serialization Anomaly |
|---|---|---|---|---|
| Read Uncommitted* | No | Yes | Yes | Yes |
| Read Committed (default) | No | Yes | Yes | Yes |
| Repeatable Read | No | No | No | Yes |
| Serializable | No | No | No | No |
*PostgreSQL treats Read Uncommitted as Read Committed. Repeatable Read trong PostgreSQL dùng snapshot cố định cho cả transaction nên cũng không có phantom read, chặt hơn mức chuẩn SQL yêu cầu.
-- Set per transaction
BEGIN ISOLATION LEVEL REPEATABLE READ;
-- ... operations
COMMIT;
# partitioning
-- Range partitioning (by date)
CREATE TABLE orders (
   id UUID,
   created_at TIMESTAMP NOT NULL,
   user_id UUID,
   total DECIMAL,
   PRIMARY KEY (id, created_at) -- khoá chính/unique của bảng partition phải chứa cột partition
) PARTITION BY RANGE (created_at);

CREATE TABLE orders_2024_01 PARTITION OF orders
   FOR VALUES FROM ('2024-01-01') TO ('2024-02-01');
CREATE TABLE orders_2024_02 PARTITION OF orders
   FOR VALUES FROM ('2024-02-01') TO ('2024-03-01');

-- Query tự động chỉ scan partition cần thiết (partition pruning)
SELECT * FROM orders WHERE created_at >= '2024-01-15' AND created_at < '2024-02-01';
-- → chỉ scan orders_2024_01
-- (chỉ có >= '2024-01-15' thì phải scan cả orders_2024_01 lẫn orders_2024_02)
# connection pooling
Như đã nói ở trên, PostgreSQL dùng Process-per-connection, nên mở thẳng hàng nghìn kết nối là tự bắn vào chân. Phải có connection pooler (như PgBouncer), hoặc ít nhất cũng tối ưu ở tầng application (HikariCP trong Spring Boot).
# HikariCP (Spring Boot default)
spring:
  datasource:
    hikari:
      maximum-pool-size: 20 # max connections
      minimum-idle: 5 # min idle connections
      connection-timeout: 30000 # wait for connection (ms)
      idle-timeout: 600000 # close idle connection after 10min
      max-lifetime: 1800000 # max connection age 30min
      leak-detection-threshold: 60000
Rule of thumb: pool_size = (core_count * 2) + effective_spindle_count Thường: 10-20 connections cho hầu hết workloads.
core_count ở đây là số core của máy chủ database, và con số này là tổng cho cả hệ thống. Chạy 10 instance app, mỗi cái pool 20 thì database phải gánh 200 connection, vượt xa con số công thức gợi ý. Lúc đó PgBouncer (transaction pooling) đứng giữa sẽ đỡ hơn nhiều so với tăng max_connections.
# useful queries
-- Active connections
SELECT pid, usename, application_name, state, query_start, query
FROM pg_stat_activity WHERE state = 'active';

-- Table sizes
SELECT relname, pg_size_pretty(pg_total_relation_size(relid))
FROM pg_catalog.pg_statio_user_tables ORDER BY pg_total_relation_size(relid) DESC;

-- Index usage
SELECT indexrelname, idx_scan, idx_tup_read, idx_tup_fetch
FROM pg_stat_user_indexes ORDER BY idx_scan DESC;

-- Unused indexes (candidates for removal)
-- Bỏ qua unique index (đang giữ ràng buộc). Số liệu tính từ lần reset stats gần nhất
-- và riêng cho từng node: index không dùng ở primary có thể đang phục vụ query trên replica
SELECT s.indexrelname, s.idx_scan
FROM pg_stat_user_indexes s
JOIN pg_index i ON i.indexrelid = s.indexrelid
WHERE s.idx_scan = 0 AND NOT i.indisunique;

-- Long running queries
SELECT pid, now() - pg_stat_activity.query_start AS duration, query
FROM pg_stat_activity WHERE state != 'idle'
ORDER BY duration DESC LIMIT 10;

-- Dead tuples (need vacuum)
SELECT relname, n_dead_tup, last_vacuum, last_autovacuum
FROM pg_stat_user_tables WHERE n_dead_tup > 1000 ORDER BY n_dead_tup DESC;

-- Lock conflicts (PostgreSQL 9.6+)
-- pg_blocking_pids bắt được cả chờ row lock (transactionid), thứ mà join theo relation bỏ sót
SELECT blocked.pid, blocked.query,
       blocking.pid AS blocking_pid, blocking.query AS blocking_query
FROM pg_stat_activity blocked
JOIN pg_stat_activity blocking ON blocking.pid = ANY(pg_blocking_pids(blocked.pid));
# spring data jpa tips (với postgresql)
# stringtype=unspecified issue
Lỗi kinh điển: truyền tham số null vào query, Hibernate (hay gặp nhất ở bản 5.x) không biết kiểu của giá trị null nên bind nó như dữ liệu nhị phân, PostgreSQL nhận về bytea và báo không tìm được function lower(bytea). Tham số có giá trị thì chạy bình thường, nên lỗi này hay lọt qua test.
// JPQL FAILS khi :email = null:
@Query("SELECT u FROM User u WHERE LOWER(u.email) = LOWER(:email)")
// Error: function lower(bytea) does not exist

// FIX: Native query với CAST
@Query(value = "SELECT * FROM users WHERE LOWER(CAST(:email AS text)) = LOWER(email)", nativeQuery = true)
List<User> findByEmail(@Param("email") String email);

// Nullable params FIX:
@Query(value = "SELECT * FROM orders WHERE (CAST(:status AS text) IS NULL OR status = CAST(:status AS text))", nativeQuery = true)
List<Order> findByStatus(@Param("status") String status);

// Còn stringtype=unspecified trên JDBC URL là chuyện khác:
// jdbc:postgresql://host:5432/db?stringtype=unspecified
// → driver gửi String dạng "unknown" để server tự suy ra kiểu, hay dùng khi
//   bind String vào cột uuid / jsonb / enum mà không muốn CAST từng chỗ
# enum handling
// Enum phải convert sang String trước khi pass vào native query
String statusStr = status != null ? status.name() : null;
repository.findByStatus(statusStr);
Nếu cột trong database là kiểu enum của PostgreSQL (CREATE TYPE order_status AS ENUM ...) chứ không phải varchar, thì so sánh với text sẽ báo lỗi operator does not exist; khi đó phải CAST(:status AS order_status) hoặc bật stringtype=unspecified.
# production checklist
Muốn đêm ngủ ngon thì tick đủ mấy ô này:
- Đã cấu hình Connection Pooling (HikariCP / PgBouncer).
- Chỉnh Autovacuum cho các bảng write nhiều.
- Soi EXPLAIN cho các query quan trọng, chắc chắn plan hợp lý với số dòng thật (query lấy ít dòng thì phải đi index).
- Xoá index thừa (xem view pg_stat_user_indexes).
- Tính chuyện partitioning cho bảng trên 10 triệu dòng.
- Bật pg_stat_statements để theo dõi performance của query thật.
- Đặt statement_timeout ở mức database, tránh cả hệ thống treo vì một query lỡ tay.
- Bật Slow Query Log (log_min_duration_statement).
Chỉ là những ghi chép cá nhân với hy vọng mang lại chút giá trị. Nếu thấy hữu ích, đừng ngại chia sẻ cho bạn bè & đồng nghiệp nhé!
Happy coding 😎 👍🏻 🚀 🔥.